把一台搭载高通骁龙 8 Gen 5、24GB LPDDR5X 内存的旗舰手机,放在手里连续跑 32B 参数的 INT4 量化大模型。前十分钟,它确实能给你惊喜——每秒吐出 8 个 token,流畅度堪比云端 API。但十分钟后,如果你伸手摸一下背板,指尖传来的温度足以让你怀疑人生,而屏幕上的生成速度会肉眼可见地跌落到每秒 3 个 token。
这不是软件优化没跟上,而是物理世界的残酷真相:端侧 32B 模型的上车,撞上了一堵看不见的墙——功耗与散热的隐形天花板。
从“能跑”到“好用”的距离,隔着 15 瓦的热障
2026 年的端侧 AI 市场,风向已经变了。正如《不再迷信万亿参数2026年通专融合模型如何重塑端侧推理》中所指出的,单纯堆砌参数量在移动端已失去意义。虽然 vivo 在 2025 底发布了专为智能体打造的 3B 多模态模型,成为主流轻量级选择,但对于追求复杂逻辑推理的用户和 B 端场景,32B 依然是“甜点级”的存在——它比 7B 聪明得多,又比 70B+ 能在本地放下。
然而,32B 模型的重量,对手机硬件是巨大的考验。
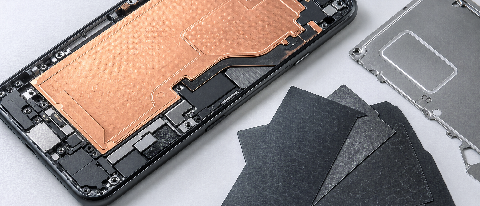
手机没有风扇。在笔记本电脑或台式机上,我们可以通过主动散热(风扇、水冷)来解决持续高负载带来的热量堆积。但在手机这个封闭且空间寸土寸金的设备里,散热主要依靠 VC 均热板和石墨烯导热片被动传导。当 NPU(神经网络处理单元)以高频率全力运转 32B 模型时,产生的热量无法快速散发,芯片就会触发**热节流(Thermal Throttling)**机制。
所谓热节流,就是芯片发现温度过高,主动降低运行频率以保护硬件。这就解释了为什么刚才那个测试中,速度会从 8 token/s 骤降至 3 token/s。这种“断崖式”的性能衰减,是端侧推理目前最大的用户体验痛点。
此外,功耗也是硬约束。骁龙 8 Gen 5 的 NPU 虽然能效比提升了 30%,但 32B 模型的推理过程依然需要持续的内存带宽支持。LPDDR5X 虽然速度快,但在大量数据搬运过程中,内存控制器本身也会发热,进一步推高整机功耗。据测试,连续运行 32B 模型 20 分钟,手机电量消耗通常在 15%-20% 之间,且伴随显著发热。
NPU 架构创新:是救星还是安慰剂?
面对这道物理题,厂商们并没有坐以待毙。2026 年,Arm 和各大芯片设计商都在尝试通过架构创新来突破瓶颈。
新一代 NPU 的设计思路,已经从单纯的“算力堆叠”转向了“稀疏化计算”和“异构调度”。例如,高通在 Snapdragon 8 Gen 5 中引入了更细粒度的 NPU-CPU 协同调度机制。对于 32B 模型,并非所有层都需要全功率 NPU 参与。通过模型剪枝和动态路由,系统可以将部分简单逻辑卸载给低功耗 CPU 核心,而将高复杂度层留给 NPU。
但这带来了一个新问题:内存墙(Memory Wall)。
32B 模型即便经过 INT4 量化,其权重数据量仍在 16GB 左右。这意味着模型必须常驻内存。在手机上,内存不仅是存储,更是数据交换的高速公路。当 NPU 需要读取权重时,数据要从 LPDDR5X 搬运到 SRAM。如果内存带宽不足,NPU 就会空转等待,不仅浪费算力,还会因为频繁唤醒内存模块而增加功耗。
这就是为什么我们在《AI算力市场变局:2026第二季度融资盘点》中看到,资本开始从“参数军备赛”转向“效率与落地”。端侧推理的核心竞争力,不再是单点算力的峰值,而是单位功耗下的有效吞吐量。谁能更好地解决内存带宽与算力的匹配问题,谁才能在 32B 模型的竞争中胜出。
隐私保护 vs. 续航噩梦:用户的真实抉择
对于普通用户来说,端侧运行 32B 模型意味着什么?
一方面,是极致的隐私保护。数据不出本地,无需联网,避免了云端 API 泄露的风险。这对于处理敏感文档、医疗记录或个人日志的用户来说,吸引力巨大。相比之下,云端 AI 虽然算力无限,但数据传输过程中的安全隐患始终存在。
另一方面,是明显的续航焦虑。如果你的手机电池容量是 5000mAh,连续跑 32B 模型 30 分钟,可能就会掉电近 20%,并且机身烫得拿不住。在这种体验下,除非你正在充电,否则很少有人会愿意将手机作为 32B 模型的常驻运行设备。
因此,目前的最佳实践是**“混合模式”**:日常轻量的指令(如翻译、摘要、简单问答)由 3B-7B 的小模型在端侧完成,确保零延迟和低功耗;而当遇到复杂的逻辑推理、长文档分析或多模态深度理解时,再通过 5G/Wi-Fi 6E 网络无缝切换到云端大模型。
这种“端云协同”的策略,既利用了端侧的隐私和低延迟优势,又弥补了端侧算力有限的短板。正如《视觉语言模型进化:2026年多模态理解瓶颈在哪》所分析的,多模态理解的复杂性正在指数级上升,单一的设备很难兼顾所有场景。
结语:32B 只是起点,而非终点
32B 模型在手机上的落地,是一个重要的里程碑,但它也清晰地揭示了端侧 AI 的物理极限。随着模型规模的继续扩大,或者对实时性要求的进一步提高,手机散热和功耗管理的压力只会更大。
未来的竞争,将不再局限于“谁能跑得动更大的模型”,而是“谁能在更低的功耗下,提供更稳定的推理体验”。这需要芯片厂商、手机品牌和大模型开发者的共同协作,从算子优化、内存管理到散热材料进行全面革新。
对于用户而言,或许我们需要重新审视对“端侧大模型”的期待。它不会完全取代云端,也不会让手机变成小型服务器。它更像是一个高效的“预处理中心”,在本地完成初步筛选和隐私保护,再将关键任务交给云端。在这个分工明确的 AI 生态中,理解物理约束,才能找到最佳的使用路径。
毕竟,没有人希望为了隐私,而牺牲掉整个下午的续航。