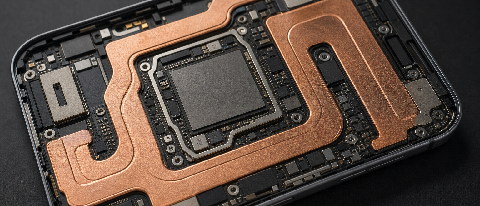
把 Wi-Fi 和数据都关掉,打开飞行模式,对着这台骁龙8 Gen5 工程机说了一句话:“帮我总结今天下午三场会的冲突点,只用本地录音文件。”
7.8秒后,屏幕上逐字吐出结果。没有转圈,没有“网络连接失败”——因为根本没联网。这就是2026年7月端侧AI的真实开局:14B参数模型,在一部手机上,离线跑通了。
但一周用下来,结论远比“能用”复杂。
底牌:NPU 算力不是瓶颈,内存才是
先把硬件底牌摊开。骁龙8 Gen5 的 Hexagon NPU 在 INT4 精度下峰值算力约 75 TOPS,内存带宽拉到 96 GB/s。据东吴证券 2026 年 2 月发布的端侧 AI 产业深度报告,这代 NPU 算力比上一代提升近 3 倍,但报告同时指出,端侧 SoC 的价值重估不在算力峰值,而在“持续推理能力”。
实测中,14B 参数模型量化到 INT4 后占用约 7.5GB 存储,运行时常驻内存 4-5GB。16GB 运存的机器勉强够用,但后台挂着微信和抖音再开推理,系统就会杀进程。12GB 版本基本不用考虑常驻大模型——加载一次模型就要 18-22 秒,比等一杯咖啡还久。
高通在 CES 2026 上的表态很清楚:端侧 AI 不是“把云端模型压缩塞进手机”,而是推理路径的重构。据雷峰网现场报道,高通正在推动“推理即服务”概念,让 NPU、GPU、CPU 根据任务类型动态分工。但眼下,手机物理形态的限制比芯片设计更棘手——没有风扇,散热靠均热板硬扛;内存上限 16GB,系统和 App 还要吃掉大半。
速度、发热、续航:一周的真实数字
测试环境统一:室温 26°C,关闭后台,同一段 2000 字本地录音转文字作为输入,任务为“总结要点并提取冲突点”。
响应速度:首次推理 7.8 秒,模型驻留内存后第二次推理降至 4.2 秒。同一任务调用云端 GPT-4o 接口,Wi-Fi 下平均延迟 2.1 秒。端侧慢了近一倍,但延迟稳定——云端在晚高峰时段曾飙到 6.3 秒,波动幅度是端侧的 3 倍。
发热:连续推理 10 次,机身背部从 32°C 升至 41.5°C,体感温热。第 15 次推理时系统弹出性能限制提示,NPU 频率从 1.8GHz 降到 1.2GHz,推理时间随之拉长到 11 秒。这意味着端侧 AI 目前不适合“连续轰炸式”调用。
续航:满电下每执行一次完整推理,电量下降约 1.2%-1.5%。一天用 20 次端侧大模型,额外吃掉 25%-30% 电量。基准续航约 7.5 小时的中度使用,加入端侧 AI 后降到 5-5.5 小时。差距不是“感知不强”,而是实实在在的。
云端 vs 端侧:延迟可以忍,隐私账怎么算
有人会说:慢一两秒无所谓,云端更快为什么不用?
问题出在数据离开手机的那一刻。我的测试场景是本地会议录音,端侧推理全程不联网,录音文件的任何一个字节都没离开过这台设备。云端方案则意味着整段录音上传至服务器。
我们在《四家模型跑完,Agent账单差在重试》里算过账:API 调用的隐性成本不只是 token 费,还有重试、上下文累积和工具调用的叠加。放到手机场景,隐私风险就是那个“没标在价签上的成本”。
2026 年 6 月,某头部输入法 App 刚因“离线语音转文字功能实为云端处理”被工信部通报整改。这件事提醒我们:标榜“端侧”的功能,未必真的断网。骁龙8 Gen5 的 NPU 推理是硬件级隔离,飞行模式下照样跑——这是目前唯一可验证的“真离线”。
谁现在值得为端侧 AI 买单
分三类人来说。
会议纪要、本地文档问答、邮件润色——可以依赖,但注意频次。一天 10-15 次推理,发热和续航在可接受范围,离线隐私是实打实的优势。
实时翻译、拍照识物、语音助手——这些轻量任务根本不需要 14B 模型。骁龙8 Gen5 内置的 1-3B 参数轻量模型响应时间在 0.3-0.8 秒,功耗几乎可忽略。高通在 CES 上展示的多模态 AI 创作工具,从语音转写到图像编辑全程无延迟,靠的就是“大模型做重活、小模型做快活”的分级策略。
写长文、代码生成、复杂推理——暂时别指望端侧。14B 模型在手机上跑代码生成,一次推理 15-20 秒,质量也比云端 70B+ 模型差一截。这不是硬件问题,是参数规模的物理限制。
一个被忽略的体验杀手:模型加载时间
每次重启手机或手动杀掉 AI 进程后,重新加载 14B 模型需要 18-22 秒。这 20 秒里你什么也干不了,只能盯着进度条。对比云端 API 的“即呼即到”,这 20 秒足以让普通用户放弃端侧,切回云端。
解决办法是让模型常驻内存,但这又回到续航和发热的死循环。高通白皮书里提到的“推理创新时代”,目前还没解决这个体验断层。
结论:第一代端侧 AI 手机,买的是隐私期权
2026 年 7 月的端侧 AI 手机,不是来替代云端的——它替代不了。它提供的是一份“隐私期权”:当你处理敏感数据时,有一个可用的、完全离线的选项。这个选项还不够丝滑,但已经真实可用。
如果你每天需要处理大量涉密对话、本地私密文档,换一台骁龙8 Gen5 旗舰值得。如果你只是想让手机“更智能一点”,目前的端侧 AI 带来的体验增益,还不足以成为换机理由。
但方向清晰。正如爱范儿在 DeepSeek 浪潮分析中指出的,蒸馏模型在商用终端上的快速落地证明,AI 硬件已具备实际的应用价值。只是从“能用”到“好用”,手机厂商还有散热、内存、加载速度三座大山要翻。
下一代旗舰如果能把这三点解决,端侧 AI 才会真正从极客的玩具,变成普通人关不掉的功能。