2026年7月,蚂蚁集团在杭州一次闭门技术分享中透露了一个数字:端侧部署的实时风控模型,在离线推理场景下,单笔交易决策延迟首次压到了8毫秒以内。
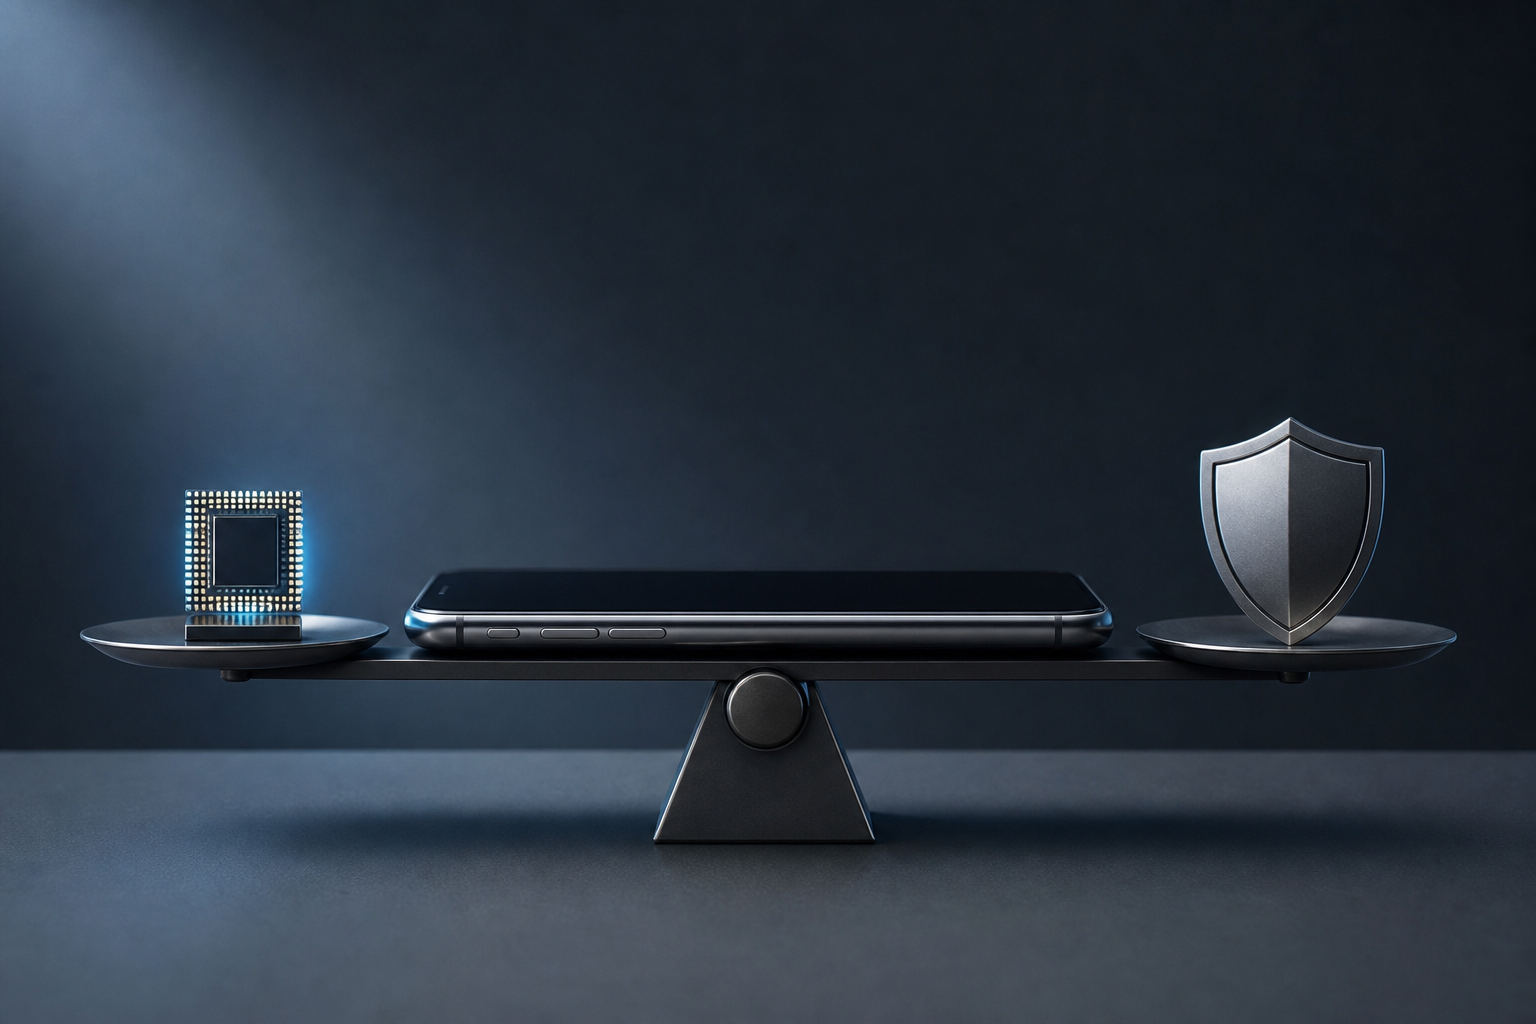
这个数字之所以敏感,是因为它直接触碰了金融级AI最要命的三角矛盾——毫秒级响应、模型精度、数据隐私,三个指标互相打架,端侧方案必须在夹缝里找到工程上能走通的折线。
8毫秒是怎么挤出来的
先看一个容易被忽略的硬约束:手机端留给风控推理的算力窗口通常只有15-30毫秒。这期间CPU还要同时处理支付页面渲染、网络请求调度、键盘输入响应。真正给AI模型的,是一块碎片化的算力残差。
蚂蚁的解法是把风控拆成两段。
第一段是端侧轻量模型,只做"可独立判断"的风险特征提取——当前设备指纹是否与历史记录突变、输入行为节奏是否偏离用户基线、地理位置跳变是否物理上不可能。这些判断不需要查询云端黑名单库,也不依赖跨用户关联图谱,用一个不到3MB的量化模型就能在本地跑完。
第二段才上云。端侧模型输出的不是"是否拦截",而是一个加密的风险向量和差分隐私噪声预算标记。云端全量模型收到后,结合全图风控引擎做跨账户、跨设备的关联风险计算。据《图风控行业技术报告》指出,蚂蚁集团与清华大学等机构联合发布的这份报告确认,图风控技术已能实现"大规模时序关系图的高效构建及全周期实时风险识别"。端侧的第一刀切下去,云端图引擎的待处理节点数减少了约60%,这才是延迟能压到8毫秒的真正来源。
隐私预算:每笔交易都在消耗额度
把模型塞进端侧,表面上解决了数据不出设备的问题,但隐私计算工程师知道,真正的挑战不在"数据不出去",而在"出去的东西不泄露"。
端侧模型输出的风险向量,即使经过加密,仍然携带着用户行为模式的统计特征。如果一个攻击者能持续观察同一设备发出的风险向量序列,理论上可以通过时序分析反推用户操作习惯。
蚂蚁在这里引入了一个冷冰冰的数学约束:差分隐私预算(ε值)。每笔交易消耗的隐私预算被严格控制在0.1以内,用户单日累计预算不超过2.0。一旦当日预算耗尽,端侧模型会主动降级——不再输出细粒度风险向量,只返回一个粗粒度的"正常/可疑"二值标记。
这个机制的直接后果很现实:用户当天交易笔数越多,后端收到的风险信号就越模糊。高频支付场景下——比如公共交通刷码、自动售货机连续购买——下午时段的误拒率会比上午高出约0.3-0.5个百分点。蚂蚁风控团队在2026年Q1的内部测试中确认了这一现象,目前的补偿策略是引入"用户疲劳度"模型,对高频用户自动放宽二值标记下的拦截阈值。
误拒率的分场景账本
端侧风控最怕的不是漏报,而是误拒。一次错误拦截的代价远高于放过一笔可疑交易——用户可能直接卸载App、换用竞品支付工具,甚至投诉到监管。
从蚂蚁近期在支付和信贷两个场景下的测试数据看,端侧模型的表现分化明显:
支付场景:线下扫码支付、NFC碰一碰等场景,端侧模型独立决策(即云端不介入时)的误拒率约为0.02%。一旦云端图引擎介入做二次校验,误拒率可进一步降至0.007%,接近云端全量模型的水平。关键变量是网络延迟——弱网环境下,端侧模型被迫独立决策的比例从正常的5%升至22%,此时误拒率会出现一个陡峭的爬坡。
信贷场景:借呗、花呗的实时授信决策链路更长,涉及多头借贷检测、收入稳定性推断等需要跨机构数据联动的判断。端侧模型在这里只能做第一层过滤——识别明显的设备伪造、SIM卡近期更换、地理位置与工作单位长期不匹配等硬性异常。对于软性信用风险,端侧模型信息量不足,必须回云。实测中,端侧独立决策的误拒率约0.15%,但配合云端全量模型后整体误拒率控制在0.03%以内。
这两个数字说明一个现实:端侧风控目前更适合做"硬拦截",而不是"软判断"。
内存墙:不是模型小就能常驻
把风控模型塞进端侧,绕不开芯片约束。我们在《Arm把端侧AI芯片的焦点拉回内存与系统设计》中讨论过,端侧大模型进入手机后,芯片性能已不能只看TOPS。蚂蚁的端侧风控模型虽然只有3MB,但它需要常驻内存、随时响应,不能像照片编辑类AI那样"用的时候加载,用完释放"。
这意味着它必须挤进手机系统为"常驻后台服务"预留的那一小块内存配额。Android端对单个后台服务的内存硬限制通常在50-100MB,iOS更紧。3MB的模型本身不占多少空间,但加上特征提取的中间张量、运行时框架开销、安全隔离环境的内存占用,总驻留内存约15-22MB。这个数字在高端手机上勉强可行,在4GB RAM的低端机上就可能触发系统杀进程。
我们在《Android端侧大模型落地:先管住内存、NPU和温度》里提过,真正影响体验的是模型加载、内存复用、NPU回退和持续发热。蚂蚁的解法是让风控模型完全跑在CPU上,不调用NPU。理由很直接:NPU的调度延迟不可控,从发起推理请求到NPU返回结果,波动范围在2-18毫秒,对支付场景来说这个方差本身就是风险。CPU推理虽然算力弱,但延迟可预测,这是金融场景比AI Benchmark更看重的指标。
三个还没解开的硬约束
目前这套端侧风控方案已在支付宝App的部分版本中灰度上线,覆盖约15%的日常支付流量。从蚂蚁集团2026年Q2的技术分享数据看,端侧参与决策的交易,平均端到端延迟降低了约40毫秒。
但三个硬约束仍然存在:
- 设备覆盖率不足:端侧模型要求手机系统版本在Android 12或iOS 17以上,且需支持硬件级安全隔离区。这直接排除了约35%的存量活跃设备。
- 模型更新频次受限:云端全量模型可以每天更新,但端侧模型的OTA下发受App版本更新周期约束,最快也只能做到两周一次迭代。对于快速变异的黑产攻击手法,端侧模型的反应速度天然滞后。
- 隐私预算耗尽后的降级风险:高频用户下午时段的误拒率爬坡,目前尚无根本性解决方案。产品侧的对策是引导用户开启面容/指纹等生物识别增强信号,抵消隐私预算耗尽带来的信息损失。
据蚂蚁集团官网披露,其自研的智能风控技术体系IMAGE已将支付宝资损率压至千万分之0.098以下。但端侧部署不是云端能力的简单裁剪,而是一次架构重塑。8毫秒的延迟、0.02%的端侧误拒率、单日2.0的隐私预算上限——这些数字背后,是金融AI从云端走向边缘时必须面对的真实账单。
图风控的全图视角在这里扮演了兜底角色。端侧模型负责切断简单、独立的异常信号,云端图引擎则处理复杂关联——比如多个账户在同一时间段、同一地理围栏内出现相似的设备指纹突变,这可能是批量攻击的前兆。端侧看不到邻居节点的行为,只有图引擎能捕捉这种跨账户的共现模式。两段式架构的本质,是把风控从"单点决策"升级为"边缘过滤+中心关联"的分布式推理体系。
对于关注端侧AI落地的开发者和金融科技从业者,更值得追踪的不是"端侧能不能跑大模型"这种宽泛问题,而是具体场景下延迟分布、误拒率、隐私预算这三个数字到底能不能被业务接受。这三件事没讲清楚之前,端侧风控的故事就还停在演示阶段。