3D视觉最费人的部分,常常发生在训练之前。机械臂要认出零件,机器人要执行“把桌上的书放到书架上”,数据里先得有人标出物体、位置和关系。2D图像还能画框,到了点云和室内扫描,还要处理深度、视角与空间结构。场景一多,标注就成了数据瓶颈。
在一份CVPR 2026 3D视觉前沿梳理中,《3D-VL: Self-Supervised Pre-Training for 3D Vision-Language Modeling》被用来说明一种新做法:把自监督学习和显式3D重建放到同一套训练框架里,让模型在不依赖3D标注的情况下学习空间表征。
这句话得拆开看。减少3D标注,不等于训练时什么配对数据都不要。它减少的是逐点、逐物体的密集标签,把更多学习信号交给场景重建和跨模态配对。把它概括成“再也不用手动标注”,边界就说大了。
重建管几何,语言管关系
3D-VL同时安排了两类任务。
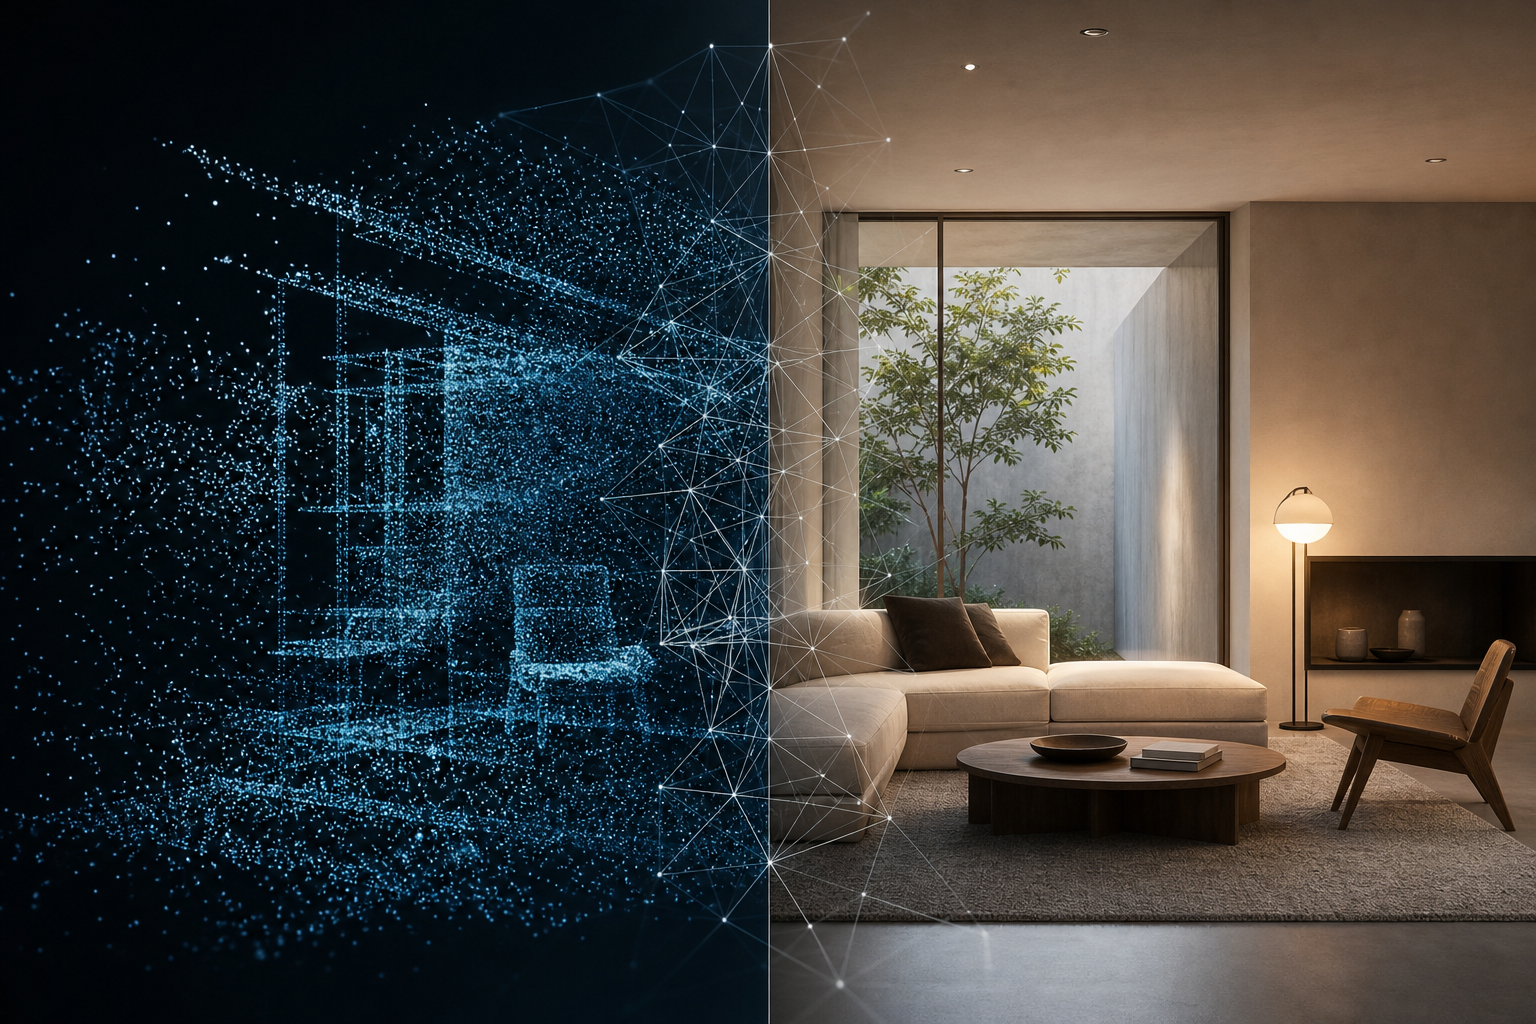
一类是NeRF重建。NeRF根据空间位置和观察视角预测颜色、透明度,再合成新视角图像。画面还原得不对,说明模型对场景几何掌握得不够。与只在隐式特征空间里做视角合成的方法相比,重建任务给模型增加了更直接的空间约束。
另一类是对比学习。系统把3D场景与自然语言描述放在一起,例如“左边是红色沙发,右边有窗户”,同时混入来自其他场景的错误描述。训练目标很直白:正确的场景—文本配对靠近,错误配对远离。这与CLIP在2D图像和文本之间建立对应关系的思路相似,只是对象换成了3D场景。
一个检查场景是否还原,一个检查场景是否说对。训练可从ScanNet等无标注场景中学习,再面向ScanQA等3D问答任务微调。它要提供的是可迁移的空间表征,而不是直接替代所有下游标注。
68,000个场景,仍然说明数据很贵
北京通用人工智能研究院(BIGAI)发布的SceneVerse,相关论文发表于ECCV 2024。BIGAI将其称为国际首个百万级三维视觉—语言数据集:覆盖68,000个室内场景,包含250万组高质量视觉—语言配对。
这组数字更像一把尺子。即使做到百万级,数据仍集中在有限的室内场景中;如果每增加一种环境都重新制作精细标签,成本很难随着场景数量同步扩张。
自监督学习并没有让SceneVerse这类数据集失去作用。更合理的分工是:未标注扫描或视频先用来学习几何,高质量视觉—语言配对再负责校准语义和具体任务。人工数据仍然重要,只是不必承担全部预训练工作。
机器人会看房间,还不等于会做事
BIGAI把三维视觉语义落地,也就是3D Vision-Language Grounding,称为具身智能的核心任务。机器人收到“把桌上的书放到书架上”的指令后,至少要识别桌子、书和书架,判断三者的位置,再把语言转成可执行动作。
3D-R1把重点放在更通用的三维视觉语言模型和推理能力上,相关介绍称其在多个3D任务中取得了性能提升。不过,静态场景理解仍不是机器人的全部能力。
文章《不好意思,机器人无法仅靠视觉理解世界》提到,模型还需要从大规模未标注视频中学习时序信息和行为模式。重建一间屋子,可以告诉机器人物体在哪里;理解动作发生后场景会怎样变化,则需要连续视频和行为数据。《中国图象图形学报》刊发的三维视觉理解综述,也将相关研究放在多模态大模型框架下讨论。
三类场景,不能套用同一个结论
- 工业与仓储:仓库布局或零件种类变化后,预训练模型有机会减少重复制作3D标签的工作量。但面向抓取、分拣等具体任务,仍需要专门数据做微调和验证。
- AR/VR与空间计算:设备必须知道墙面、桌面和物体的位置,虚拟内容才能与真实环境正确对齐。3D重建与语言理解的结合,和这类需求直接相关。
- 自动驾驶与Robotaxi:道路是持续变化的动态场景。室内数据集上学到的空间表征,不能直接等同于车辆在复杂道路中的判断能力,还要结合时序、多传感器数据和安全验证。
NeRF训练和渲染还会增加计算负载。这类模型能否进入消费级设备或车端,不能只看3D问答任务的分数,还要评估训练成本、推理延迟和资源占用。现有公开材料没有给出这些指标,暂时不能提前下结论。
3D-VL处理的是一个窄而实际的问题:能否用场景重建和视觉—语言对齐,替代一部分密集3D标注。它没有让标注员消失,也没有单独解决机器人理解世界的问题。
但训练顺序确实变了。先从未标注场景里学习空间,再用SceneVerse这类高质量数据校准语义和任务能力。对照68,000个场景和250万组配对数据,这种分工比“零标注”的口号更接近工程现实。