医生才是AI读片结果的第一责任人
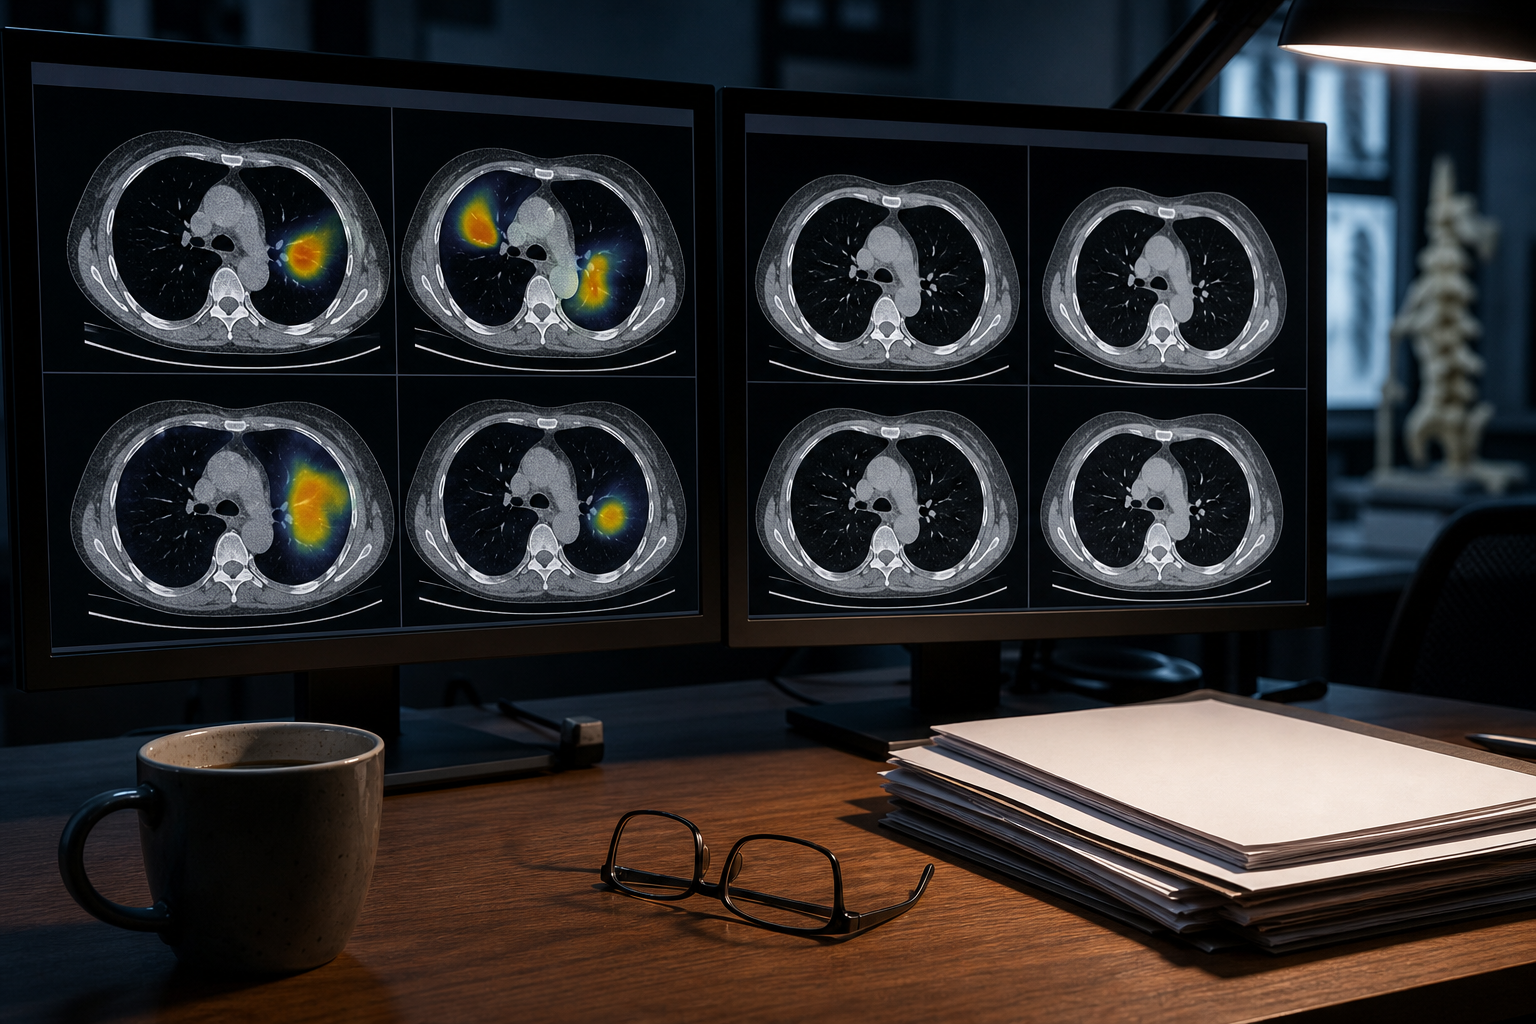
上海某三甲医院影像科主任周明拿到一份肺结节筛查的AI报告,习惯性地扫一眼模型给出的热力图,再去看原始CT。这一动作他每天要重复80多次。
这不是什么"AI替代医生"的剧本。据《中国医学影像AI发展研究报告(2026)》披露的临床数据,AI模型在三甲医院影像科的真实位置,是承担"二读"——也就是在医生完成第一遍读片之后,再由模型独立过一遍,然后双方结果比对。这一制度安排,源于2025年国家卫健委发布的《医学影像人工智能辅助诊断应用质量控制指南》,指南明确要求AI结果必须经过放射科主治医师以上人员签发,不得作为最终诊断。
换句话说,医生签字,模型担责——这句话倒过来才是现实。
选型:不是挑参数,是挑场景
这家医院的AI选型流程,从2024年下半年开始迭代,现在已经走完三轮。
第一轮是2024年初,科室试用了5款商用肺结节筛查模型,跑的是公开数据集LIDC-IDRI。结果显示,5款模型的敏感度都在95%以上,FROC曲线差别不到两个百分点。周明看完报告的第一反应是:"这些参数没意义,真实临床数据不是这个分布。"
第二轮改成了院内回顾性研究。把2023年全年的12000例胸部CT拿出来,每个病例由两名高年资主治医师双盲标注,作为金标准。再让5款模型分别在内部数据上跑一遍。这次的差异拉开了:有的模型对磨玻璃结节召回率骤降到82%,有的对实性结节过召回,平均每例多报3个假阳性。
这一轮筛掉了3款模型。剩余2款被引入到第三轮,也就是真实工作流试运行。
据中国新闻周刊2026年5月专题"夯实数据底座 AI医学影像破局前行"报道,AI医学影像已经在病灶筛查、疾病鉴别、急症救治多个场景落地,但模型表现高度依赖训练数据与目标人群的匹配程度。这一结论在这家医院的选型过程中被反复验证——任何脱离场景谈参数的行为,都是采购前的无效决策。
二读流水线:从排队到签发的23分钟
模型的接入位置很微妙。它不进入PACS的写流程,而是独立挂在RIS(放射科信息系统)之后,作为一道并行环节。具体节奏如下:
患者做完CT,影像先传到PACS,值班住院医读片,给出初步意见;同时,原始DICOM文件被一份副本推送到AI推理服务器,模型在90秒内返回结构化结果,包括结节位置、直径、密度分类、恶性概率评分。这条结果会以"AI参考意见"的形式,叠加在PACS阅片界面的右侧栏。
主治医师拿到片子开始正式读片时,模型结果已经在屏幕上。医生要做三件事:一是看自己有没有漏掉模型挑出来的高风险点(漏检复核);二是看模型有没有把正常结构识别成结节(误报复核);三是综合两边意见,写出报告并签发。
医院信息科做过一次内部测算:AI加入后,单个胸部CT的平均阅片时间从原来纯人工的14分钟,变成了现在的9分钟;但加上模型结果复核、AI系统卡顿等待等情况,完整流程平均耗时23分钟。也就是说,医生在单位时间内处理的病例数并没有显著增加,但单例的判断密度明显提高。
周明对这个结果的态度很克制:"AI不是省时间,是省漏诊。"他举了一个例子,2025年12月的一次夜班,模型在一例急诊胸痛CT中标记了一个6mm的左肺下叶磨玻璃结节,值班住院医第一遍没有注意到,因为注意力被锁在主动脉夹层的排查上。住院医看到AI提示后回头复查,补报了这一结节。三天后随访证实为早期腺癌。
数据标注与质控:模型可不可信,看这些环节
医院信息科主任蒋磊把这套系统的质量管理分成了四块。
第一块是金标准库。医院保留了一套独立标注的测试集,包含1500例胸部CT、800例头颅CT、600例腹部CT。每季度会更新一批新病例,确保测试集和真实世界数据分布不脱节。任何模型在引入前,都要在这套金标准上跑一遍,敏感度、特异度、每例假阳性数(FPs)三项指标全部进入采购合同附录。
第二块是反馈闭环。每一例AI结果,无论医生采纳与否,都会和最终报告一起归档。每月末,信息科会跑一次对照分析,把模型预测和签发报告的差异列出来。如果某个医生在某个病种上连续3个月和模型差异率超过15%,会触发专项复核——既可能是医生漏读,也可能是模型在退化。这是周明口中的"模型不是工具,是同事"的含义。
第三块是漂移监测。医院用自己搭建的轻量监控平台,每天统计模型输出分布。一旦某一天某类结节的平均恶性概率评分、标准差、假阳性率任一项偏离基线超过两个标准差,会自动触发告警。蒋磊说,过去一年他们触发了4次告警,3次是因为医院CT设备厂家升级了重建算法,图像纹理分布轻微漂移,导致模型输出异常。
第四块是人工复核的硬约束。所有AI标红的病灶,在签发前必须被医生点击确认"已查看";如果医生对AI结果有异议,必须填写简短理由,理由会进入复盘数据库。这一设计来自2025年质控指南的明确要求,后来被很多兄弟科室照搬。
医生真实反馈:不是惊喜,是监督
回到医生面。医院组织过一次不记名访谈,26名放射科医师参与,问题只有一个:"AI进入工作流6个月,你最大的抱怨是什么?"
排在前三的回答分别是:
第一,假阳性太多。胸片上肋骨钙化、皮肤乳头影、CT上血管断面,经常被模型标红。一例胸部CT平均有8到12个AI标记点,其中至少5个是明显假阳性。年轻医生很烦,因为他们需要在报告里逐条解释"为什么这个不是结节"。
第二,定位不准。模型给出的坐标在三维重建上经常偏移几毫米,医生想点过去看一眼原文,经常点不到。蒋磊说,这个问题和PACS、AI服务器、医院网络三方的坐标系对齐有关,解决方案并不昂贵,但需要在部署阶段就做好。
第三,更新跟不上。模型版本几个月才升一次,医生提出的"这个病灶应该这样标"的需求,从来得不到反馈。
这三条反馈指向同一个结论——AI在临床里的真实角色,不是"更聪明的医生",而是"永远在线、需要监督的二读"。
给医疗IT同行的几条经验
把这段经历复盘给同行,有几条经验可能比模型选型本身更有价值。
建议一,把AI当成一个会犯错但从不请假的住院医。不要追求零假阳性,也不要相信厂商宣称的99%敏感度。那些数字跑的是公开数据集,和你医院的扫描协议、阅片习惯、患者人群关系不大。
建议二,金标准库必须自己建。公开数据集只能筛模型,不能签合同。对外采购时,把院内金标准测试结果写进商务条款,作为付款依据,而不是只信CT报告。
建议三,质控平台要早于模型上线。很多医院AI上线后才补质控,结果出现误报没人管。漂移监测、反馈闭环这两套东西,在第一次试运行就应该准备好。
建议四,留足人工复核的UI空间。AI标红的位置、医生点击确认的路径、异议填写的入口,这些都是交互细节,但决定了系统能不能用下去。
建议五,关注模型之外的成本。推理服务器采购、GPU扩容、影像数据做去标识化存储的合规成本、模型再训练的标注成本,这些钱加起来往往超过软件授权本身。算清这笔账,参考之前昇腾910C万卡集群的运保账目会更有参考价值——能效边界、备件粒度、版本适配这些账,医疗AI也一样要算。
至于更宏观的多模型协同,也已经有公开案例可参考。比如医疗大模型走向门诊时,罕见药名识别成为一线医生最关心的指标,这套"AI先读、人工复核"的协作机制,和影像科是同一个逻辑。
最后,周明在一次科务会上说过一句话,这句话可能是当前医疗AI最贴近现实的位置描述:
"AI不会让我失业,但它让我不敢再漏诊。"
这才是二读时代的真正价值。