端侧 Agent 和“点一下、跑一次”的 AI 功能不同。它可能在后台等待输入,收到请求后调用模型,再把结果交回应用。其间还会经历暂停、恢复和优先级变化。
模型单次跑得快,不代表整机省电。只要每次切换都要 CPU 出面,响应、续航和温升仍会受影响。对笔记本、手机和车机来说,NPU 要处理的不只是推理,还有一个更琐碎的问题:能不能少叫醒 CPU。
NPU 不必包办整台设备
Arm 对异构计算的说明很直接:CPU 负责通用计算,GPU 擅长并行处理,NPU 面向 AI 工作负载。把任务交给合适的处理器,既能提高计算速度,也有助于降低能耗。
放到 Agent 里,操作系统、应用逻辑和工具调用仍要由 CPU 处理;GPU 继续承担图形和适合并行执行的任务;模型推理则尽量交给 NPU。三者没有固定的分配比例,具体要看应用。
更值得盯住的是切换成本。任务开始、暂停或调整优先级时,CPU 到底要插手多少次?
0.5% 到底省掉了什么
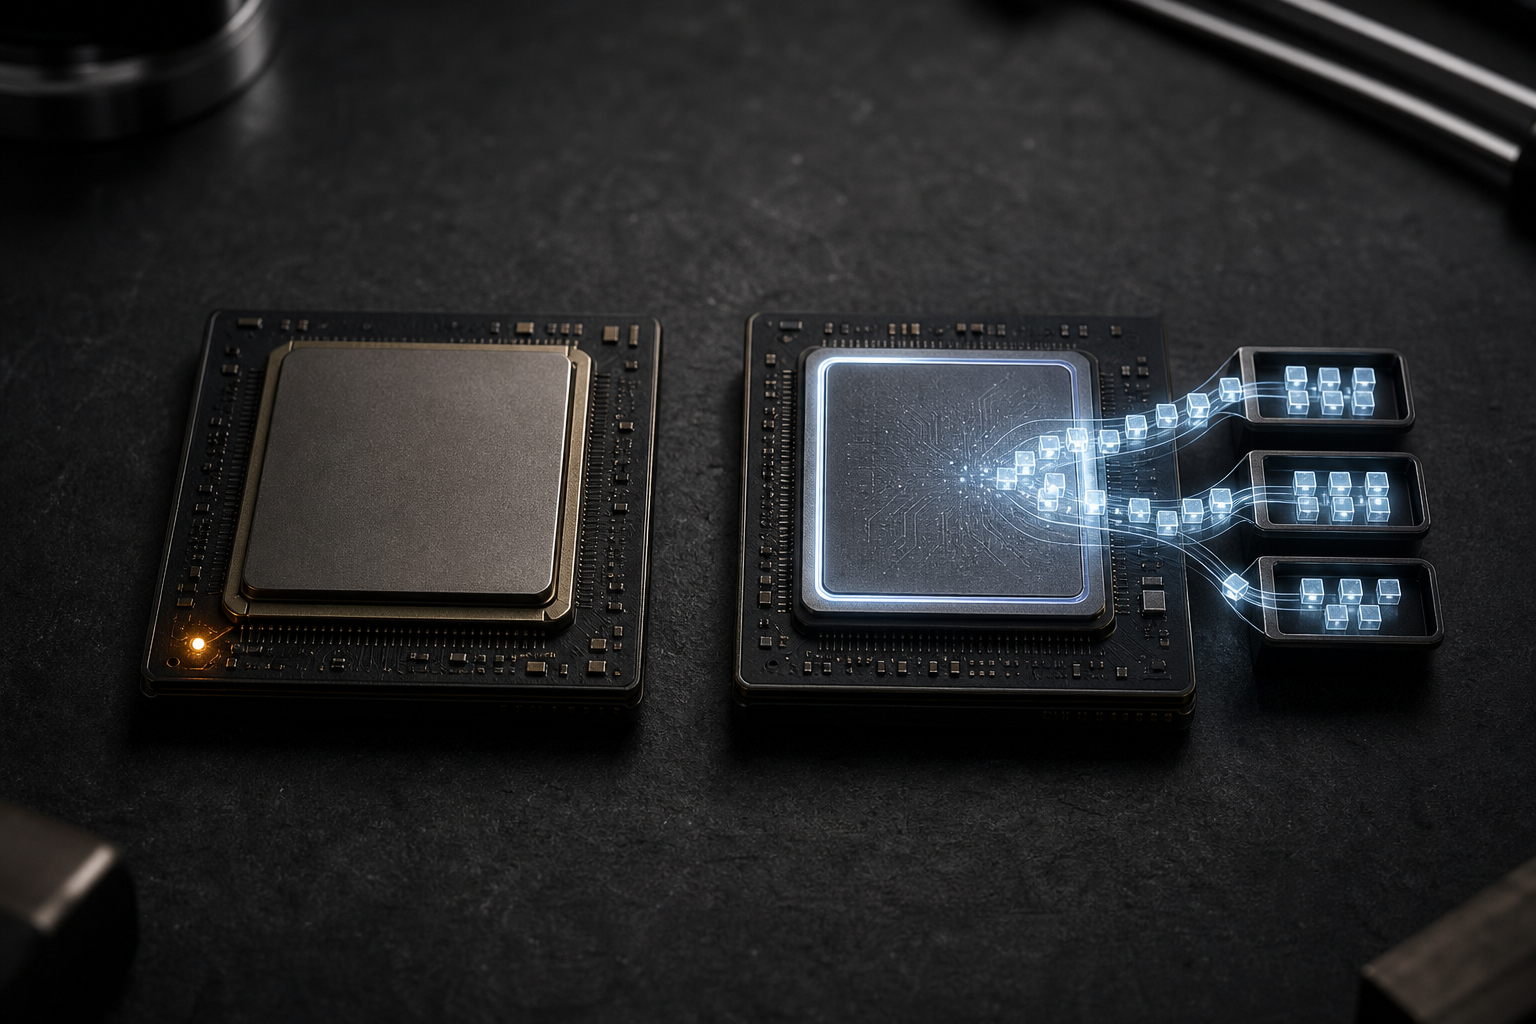
安谋科技“周易”X3 NPU 集成了 AI 专属硬件引擎 AIFF(AI Fixed-Function)和专用硬化调度器。两者不是一回事:AIFF 是专属硬件引擎,硬化调度器负责安排任务和处理优先级。
EDN China 的报道中,最醒目的数字是 CPU 负载最低可至 0.5%。报道同时提到低调度延迟,以及对端侧多任务和任意优先级调度的支持。
放到 Agent 里,这套设计针对的是前台交互与后台任务的排队和优先级切换,目标是减少 CPU 在零碎任务之间反复接手。例如用户正在输入时,交互任务可以先执行,后台摘要稍后继续。
但 0.5% 很容易被读错。它不是说整机功耗只有 0.5%,也不代表每台设备、每个模型都能复现相同结果。这个数字描述的是特定架构下的最低 CPU 负载。能得出的较窄判断是:硬化调度器可以接走一部分原本需要 CPU 参与的调度工作。
笔记本、手机、车机,各算一笔账
笔记本怕的是并发。 文档摘要、语音助手、代码辅助可能同时运行。除了单次推理速度,NPU 还要处理任务排队和优先级变化。“周易”X3 公布的多任务与任意优先级调度能力,对应的正是这类需求。
不过,现有公开资料没有给出 Arm 与 x86 在同条件 Agent 负载下的对比数据,不能据此得出某一架构全面领先的结论。
手机先算常驻账。 《AI进化加速端侧落地,新一轮换机潮蓄势待发》将 NPU 概括为专为低功耗加速 AI 推理打造。对手机来说,让意图识别、助手推理等任务尽量留在 NPU,并减少 CPU 唤醒,比单纯追求更高的峰值算力更贴近日常使用条件。
车机先排优先级。 语音助手、导航辅助、疲劳监测等任务可能同时出现,关键任务能否先执行,比总算力数字更值得关注。“周易”X3 的低调度延迟和任意优先级调度在这里有参考价值。但公开资料没有给出车机端的微秒级响应数据,也没有证明它达到硬实时要求,具体表现仍要看产品和整机实现。
本地运行,不等于隐私问题自动消失
极术社区转述的 Arm《人工智能就绪指数报告》提到,逾八成受访企业正积极采用 AI,只有 29% 能够自动扩展计算资源,近半数企业领导者担心因模型提取造成的数据隐私泄露。
这是一组企业调查数据,不是终端功耗测试。它能说明的是,企业关注本地计算,不只因为成本和延迟,也有隐私方面的考虑。
端侧推理可以减少部分数据上传需求,但不能自动保证“数据不出端”。数据最终会不会离开设备,还要看操作系统、应用和完整的数据路径。AIFF 与硬化调度器处理的是执行和调度,不能直接等同于隐私保护硬件。
判断一套端侧 Agent 方案是否省电,不能停在芯片参数页上。模型在 NPU 上跑得怎样,调度器会不会频繁叫醒 CPU,CPU 和 GPU 有没有被迫接手不合适的任务,最后都要落到整机的功耗、温度和响应时间上。
现有公开资料里,“周易”X3 最具体的锚点仍是 CPU 负载最低可至 0.5%。它表明部分调度工作可以从 CPU 手中移走,但替代不了笔记本续航、手机温升和车机响应时间的整机实测。