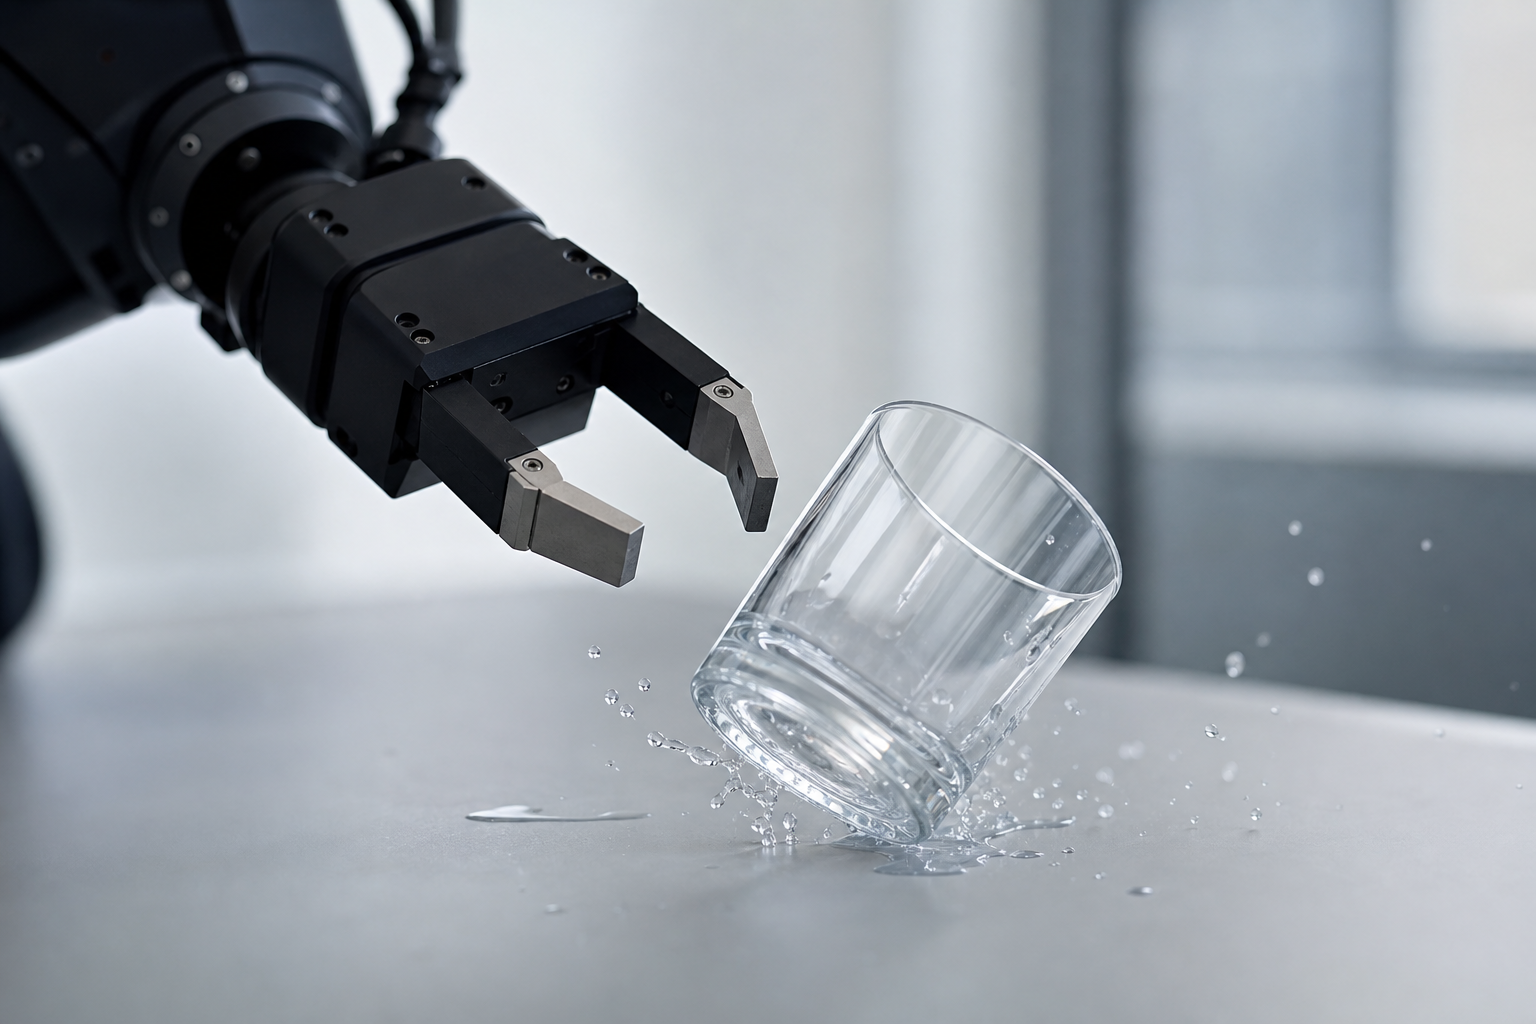
一个在仿真里能流畅解开十步操作链的智能体,接到真实机械臂上,抓一个透明水杯却连滑三次。这不是算法不够大,而是物理交互的评测标准本身,在逼着研究者重新审视“通用”二字的工程边界。
2026年7月,北京通用人工智能研究院(BIGAI)的科研进展页面上,开源不到一周便冲上 HuggingFace 热度趋势榜第一的“全能物理空间训练场”TongSIM,与宇树科技联合提出的通用运动控制框架 OmniXtreme,构成了一组难得的对照样本。前者在仿真里穷举物理任务,后者试图把仿真策略直接部署到真实机器人上。对照之下,失败案例远比成功案例更能说明当前具身智能的真实水位。
透明、反光、柔性:抓取面前的一堵硬墙
在 TongSIM 构建的虚拟场景中,BIGAI 智能体需要完成超过 200 类物体的抓取。评测报告显示,刚性不透明物体(如木块、金属零件)的单次抓取成功率可达 87% 以上。但一旦替换为透明玻璃杯、高反光不锈钢餐具或柔性硅胶管,成功率会断崖式下跌至 40% 以下。
表面上,这是个传感器融合问题:真实世界的深度相机面对透明材质会返回大量噪点,RGB 相机对高反光表面的边缘检测不稳定,触觉传感器在柔性物体形变时的力反馈延迟达到 80-120ms。但 BIGAI 团队在技术讨论中点出了一个更棘手的缺陷——智能体缺乏对“不可见部分”的物理常识推断能力。
人类抓取一个透明杯时,即便看不清杯壁厚度,也会根据杯口曲率和材质经验自动补全三维形状。而当前的通用智能体在视觉输入缺失部分深度信息时,倾向于调用训练数据中最相似的物体模板来“猜”。一旦模板与实物偏差超过 15%,抓取姿态就会产生足以导致滑脱的误差。BIGAI 将这一问题归类为“视觉与认知的联合建模不足”,而不是单纯的传感器精度问题。
避障:仿真里学到的安全距离,被电机延迟吃掉了
OmniXtreme 框架的设计初衷是攻克“泛化壁垒”——让机器人在仿真中学会托马斯全旋这类极限动作后,迁移到真实机器人上不散架。在运动控制层面,它确实做到了:宇树的 H1 人形机器人在仿真中训练出的动态平衡策略,迁移到真实机体后,动作轨迹的平均偏差控制在 3.2% 以内。
但避障场景暴露了另一层断裂。在 TongSIM 的导航避障测试中,智能体在仿真环境里能以 95% 的成功率穿过动态障碍物群,安全距离维持在 12-15cm。同样的策略部署到真实机器人上,安全距离被压缩到 5-8cm,碰撞率上升至 23%。
根因不在视觉感知环节。真实机器人的激光雷达和深度相机在障碍物检测上并没有明显劣化。问题出在执行链末端的机电延迟。从决策层发出“右转 15 度”指令到电机实际完成转角,真实系统存在 45-70ms 的通信与机械响应延迟;而在仿真中,这一延迟被理想化为零。在密集障碍物场景中,每多一层指令转发,累积误差就会吃掉仿真里预留的安全余量。
BIGAI 研究人员将这一现象定义为“仿真-现实时序不对齐”,并指出当前主流仿真平台(包括 TongSIM 自身)尚未在标准评测中引入电机响应延迟的随机扰动模型。这意味着,几乎所有在仿真中跑出高分的避障策略,迁移到真实机器人时都会遭遇未被训练过的延迟噪声。
推理链一超过 7 步,失败模式开始发散
物理交互中最考验“通用性”的,是多步骤任务规划。TongSIM 中有一个典型测试场景:智能体需要先打开柜门,取出一个装有液体的量杯,绕过地面上的线缆,将液体倒入另一个容器,最后将空杯放回原处。这一任务在仿真中的分解步数为 9 步。
BIGAI 智能体在仿真中完成该任务的成功率为 78%。但迁移到真实环境后,成功率跌至 31%。失败模式不再是单一的抓取或避障失误,而是出现了三种完全不同的崩溃路径:
- 步骤顺序僵化:智能体在打开柜门前就试图抓取量杯,因为视觉模块在柜门半透明状态下误判了量杯的可达性。这属于感知-规划耦合错误。
- 中间状态丢失:顺利取出量杯并完成液体倾倒后,智能体“忘记”了柜门仍然敞开,在返回放置空杯时撞上半开的柜门。这暴露了长推理链中的状态记忆衰减。
- 子目标替换错误:在绕开线缆时,智能体将“绕开”这一子目标错误替换为“跨过”,导致足部绊线。这是任务分解层面的语义漂移。
这三种失败模式分别对应推理链的不同环节:感知触发、状态维护和子目标执行。BIGAI 团队在 2026 年 6 月的技术讨论中坦承,当前通用智能体的推理链长度一旦超过 7 步,每一步的失败概率会从单步的 3-5% 开始非线性叠加,最终导致整体任务成功率跌破可用阈值。
这恰好回应了一个行业性的争论:具身智能的瓶颈到底在传感器融合,还是在推理链长度?BIGAI 的评测数据给出了一个偏向明确的答案——传感器融合的问题正在被工程手段逐步压缩(更好的深度补全算法、更高帧率的触觉反馈),但推理链超过 7 步后的状态管理和子目标稳定性,目前没有显示出随模型规模扩大而线性改善的趋势。
仿真到现实的迁移鸿沟,正在被重新定义
过去业界习惯将“Sim-to-Real Gap”归结为视觉域迁移和物理参数标定误差。BIGAI 这一轮评测揭示的,是两个更隐蔽的缺口:
- 时序不对齐:仿真中的零延迟执行假设,在真实机电系统中不成立,且当前评测基准未将其纳入标准扰动模型。
- 推理链深度与物理常识建模的耦合:长推理链中的状态记忆衰减和子目标语义漂移,根源在于智能体缺乏对物理世界因果结构的深层理解——它知道“绕开”这个动作,但不理解“为什么必须绕开而不是跨过”。
据 BIGAI 官网显示,其科研部门正将“通用视觉”“机器人”和“认知架构”三大方向并轨,试图用统一的认知架构来约束视觉感知和任务规划,让智能体在推理链的每一步都能调用更深层的物理因果模型,而不是仅靠端到端的行为克隆。这条路能不能走通,还要看 TongSIM 下一个版本是否会引入时序扰动和推理链深度压力测试。
但至少现在,BIGAI 的通用智能体在物理交互测试里卡住的那几关,已经足够清晰地标出了具身智能从“能跑通 Demo”到“能干活”之间,还有多少工程和理论上的硬骨头要啃。此前我们在《BIGAI通用智能体,先把评测证据讲清楚》中曾指出,讨论通用智能体必须建立在可核验的 benchmark 之上,而 TongSIM 与 OmniXtreme 的公开,至少让这场讨论有了一个可以量化的起点。