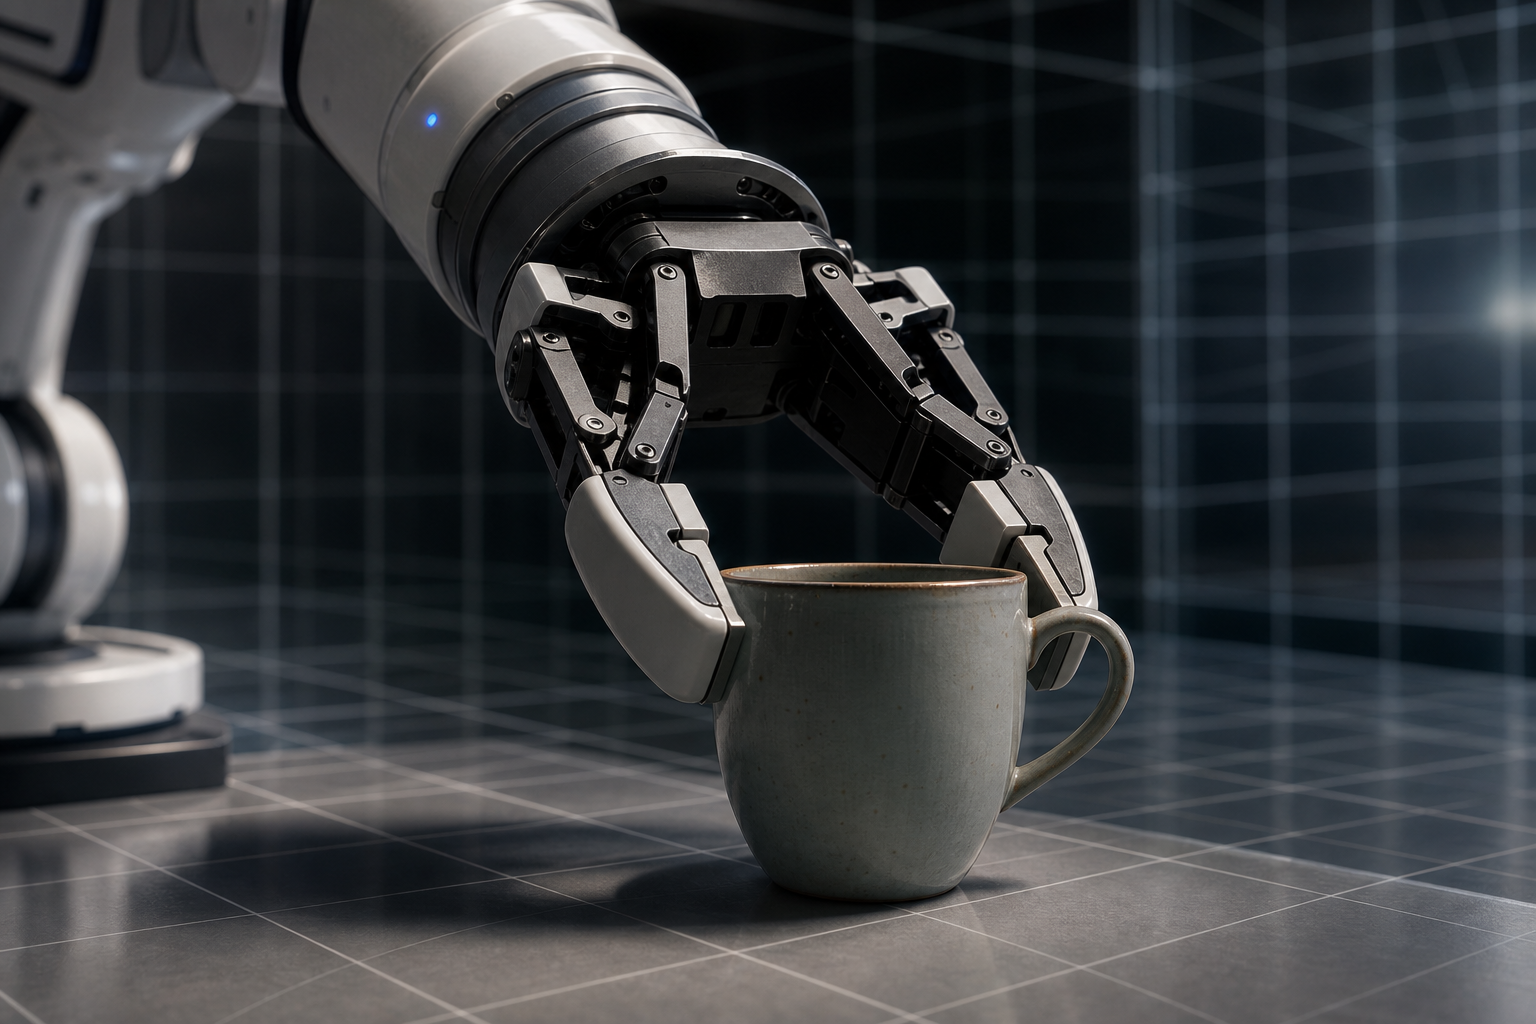
2026通用人工智能论坛上,北京通用人工智能研究院(BIGAI)把一个基于“通通”3.0的具身智能体放到展台中央。它在SceneVerse++与TongSIM构建的高保真物理环境中执行操作任务。演示直接把问题落到了动作上:模型给出的计划,能否穿过控制系统,变成准确、连续的执行。
物理世界不会给模型太多解释空间。一句“拿起杯子”,实际牵涉材质、重心、摩擦力和机械臂关节角度。任何一项判断偏了,语言上成立的方案都可能在动作中失败。这正是BIGAI押注物理推理的原因。
会写答案,离会做动作还很远
过去两年,大模型在文本理解、逻辑推理和代码生成上进步明显。以Cursor 3参与代码预审为例,它可以承担提交前的逻辑校验,但业务边界仍要由团队确认(相关内链:用cursor-30进行ai辅助代码审查团队协作模式升级)。这类屏幕内任务可以回看、撤销和重试;汽车、机械臂或无人机面对的则是连续变化的环境和实时反馈。
自动驾驶已经把这种差别暴露得很充分。即便BEVFormer迭代至第五代并完成多视角特征融合,参数减少也不等于车端稳定。算子能否落到NPU、时间戳是否对齐,都会改写实时推理表现(相关内链:别急着给BEVFormer分代,车端跑稳才是门槛)。《人民日报》2026年6月15日的文章把物理人工智能(Physical AI)概括为能感知、能行动、能在真实场景中反复试错的智能体。BIGAI的选择,正落在这组能力上。
通专融合,先把“大脑”和“小脑”接起来
通专融合的范围超过了给通用模型外挂几个小任务。相关资料将其拆成三层:基础模型层增强推理与知识解耦能力,融合协同层负责系统1与系统2的动态协作,探索进化层让AI进入物理与虚拟融合环境,通过具身交互学习。
周伯文在CNCC2024讨论的是专业性与泛化性难以兼得的问题。第一财经2024年7月5日的报道用“瞎说”“乱想”概括单沿通用大模型路线推进的风险;上海人工智能实验室对CNCC2024演讲的整理也把通专结合作为AGI路径中的关键问题。
BIGAI给出的工程表达更直观:数据—大脑—小脑—本体。大脑负责高层认知和规划,小脑处理低层运动控制与即时反应,本体是机械臂、无人机或自动驾驶汽车等实体,数据贯穿训练和反馈。这个闭环要处理的,正是“知道该做什么”与“设备能把动作做出来”之间的断层。
SceneVerse++和TongSIM,把长尾场景搬进仿真
SceneVerse++除视觉信息外,还包含物理属性标签;TongSIM则用于模拟极端天气、复杂路况等长尾场景。两者组合,为数以亿计的试错提供了数字孪生环境,也对应通专融合框架中的探索进化层。
系统1负责快速、直觉的反应,例如躲避障碍物;系统2承担较慢的逻辑规划,例如选择路径。环境突变时,智能体不能等完整规划结束后再行动;快速反应之后,又需要重新评估后续步骤。仿真可以提前暴露这类冲突,但不能直接证明真实设备已经稳定。策略从SceneVerse++、TongSIM迁移到本体后,仍要接受时延、传感和控制链路的检验。
机器人能不能用,最后看端侧
工业机器人遇到非标件时,往往需要人工重新示教。通专融合希望让具身智能体通过少量示例,适应新的抓取姿态和操作规范。更值得追问的是:换了物体、位置或节拍后,系统还能否连续完成任务,而不只是成功演示一次抓取。
硬件同样决定上限。在围绕2026年边缘AI芯片的讨论中,Arm架构被视为占据先手,但内存、算子回退以及CPU与NPU的调度,仍会影响端侧Agent的功耗和实时性(相关内链:2026年边缘ai芯片之争arm架构在推理市场的真实性能与生态壁垒;端侧 Agent 怎么省电?关键是少让 CPU 介入调度)。如果低层控制频繁回到CPU,大模型即使完成了高层规划,也很难稳定嵌入设备。
算力供给决定仿真能做多大,却替代不了闭环验证。围绕酒仙桥算力园区的讨论,已经从“8000P之后如何利用”延伸到“卖卡”“卖热”和“卖服务”(相关内链:8000P之后,酒仙桥算力园区先把利用率说清楚;算力中心从“卖卡”转向“卖热”:区域能源调度如何算账)。这些变化可能降低大规模仿真的使用门槛,但BIGAI这条路线是否成立,最终仍要看几个硬结果:仿真策略能否迁移到真实本体,大脑与小脑能否在实时约束下配合,系统遇到陌生场景时能否停下并重新规划。
物理世界之所以成为大模型的下一道考题,就在于它不给错误留出靠语言圆回来的余地。一次抓取是否成功、一段车端推理是否按时完成,比模型又增加了多少参数,更能说明通专融合走到了哪一步。