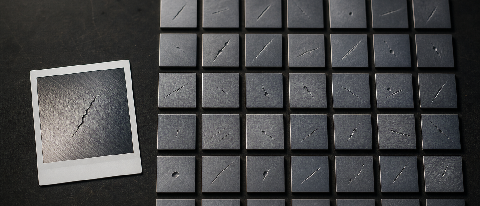
在东莞一家电子元器件工厂的SMT产线旁,工程师李工指着屏幕上的坏件图像说:“以前拍几百万张图训练,现在只要20张,模型就能学会识别这个新型焊点缺陷。”他说的“学”,用的是一种名为“扩散模型生成合成数据”的技术。这不再是C端应用里AI画画的把戏,而是制造业质检环节一次真实的技术迭代。
数据饥渴症:传统CV方案的启动成本
传统的工业质检计算机视觉(CV)方案,核心瓶颈在于“数据饥渴”。要训练一个能准确识别特定缺陷(如划痕、裂纹、污渍)的模型,往往需要标注数万张甚至数十万张的高质量缺陷样本。这在实际产线中意味着高昂的成本。
以一家年产量超2亿颗的功率半导体工厂为例,其2025年引入的传统CV质检系统,项目前期投入超过200万元。其中,数据采集、清洗和人工标注环节耗时8个月,占整个项目周期的60%。更棘手的是“冷启动”问题:每当产线引入新封装型号或出现一种新的缺陷模式,整个模型就需要用新数据重新训练,迭代周期通常在1-2个月,期间质检只能依赖人工或降低检测标准。
25张图变1万张:生成式AI的切入点
解决“数据饥渴”的关键,在于让模型“举一反三”。生成式AI技术提供了新思路:通过少量真实缺陷样本,利用扩散模型等技术,合成出海量、多样化且高度逼真的缺陷图像,用于训练检测模型。
2026年初,一家头部汽车零部件制造商(为国内主流新能源车企供应电驱系统壳体)启动了一项试点项目。他们面临的问题是:新开发的铝合金壳体上,偶尔会出现一种深度在0.1-0.3毫米之间的微观气孔。传统做法是等气孔缺陷累积到足够样本再训练模型,但这会导致大量次品流出。
试点方案中,他们仅收集了25张含有该气孔缺陷的X光图像。基于此,团队使用了基于Llama-3架构微调的工业视觉扩散模型(具体工具链细节涉及保密协议),生成了10,000张合成缺陷图像。这些图像保持了缺陷的真实物理特征,同时在光照、角度、背景上进行了充分的随机化扰动。
用这批合成数据训练的检测模型,与仅用25张真实图像训练的模型相比,在验证集上的准确率(Accuracy)从72%提升至94%,F1值从0.68提升至0.91。更重要的是,模型从启动到上线产线测试,只用了3周时间。而按照传统流程,这个周期通常需要2-3个月。
账本怎么算:一次投入 vs 反复折腾
成本结构的差异是决策的核心。我们对比了两个典型案例的数据(数据来源:企业试点项目报告及行业访谈):
| 对比维度 | 传统CV方案 (功率半导体厂) | 生成式AI辅助方案 (汽车零部件厂) |
|---|---|---|
| 前期数据成本 | >80万元(采集、标注、存储) | <15万元(少量样本采集+算力租赁) |
| 单模型训练周期 | 3-8周 | 1-3周 |
| 新缺陷迭代成本 | 高(需重新采集、标注) | 低(用旧模型生成新缺陷数据即可快速适配) |
| 首次部署总投入 | 约200万元 | 约50-80万元(含算力与模型服务) |
从ROI(投资回报率)角度看,传统方案像建造一座大坝,前期投入巨大但能长期挡水;生成式AI方案则更像搭建灵活的水闸,初始投入小,且能快速开合应对不同水流(缺陷)。对于产品迭代快、缺陷种类多变的行业(如消费电子、精密结构件),后者的灵活性和总成本优势更为明显。
然而,门槛并未消失。汽车零部件厂的试点项目负责人坦言:“最大挑战不是模型本身,而是确保合成数据的‘物理真实性’。”如果生成的缺陷图像不符合真实的材料失效物理规律(例如,生成了自然界不可能出现的裂纹纹理),模型虽然能在测试集上表现亮眼,但在真实产线上会“露馅”,产生误检或漏检。这需要领域专家深度介入,对生成的数据进行物理合理性校验。
算力、人才和闭环:落地的真实门槛
生成式AI在工业质检的落地,并非“即插即用”。目前,头部厂商的解决方案普遍采用混合架构:日常检测使用部署在产线边缘服务器上的轻量化检测模型(如基于MobileNetV3的模型),而当出现新型缺陷时,调用云端的生成式AI模型进行数据合成与模型迭代训练。这种架构既能满足实时性要求(边缘推理延迟<50ms),又能利用云端强大的生成与训练能力。
人才缺口是另一个现实问题。既懂计算机视觉、又了解材料工艺和产线逻辑的“跨界工程师”极为稀缺。上述汽车零部件厂的项目团队,核心成员包括两名光学工程师、一名材料学博士和两名算法工程师,历时4个月才打通从数据生成到产线部署的全链路。
此外,建立持续的“数据闭环”至关重要。产线上的新缺陷模式被人工确认后,应能快速触发新一轮的数据生成-训练-部署循环。这要求工厂的MES(制造执行系统)与AI平台深度集成。机器处理标准化流程效率很高,但人工确认环节目前依然是自动化流水线中的断点。