8%和1.2%看着只是两个比例。落到质检线上,每1000个次品,漏掉的数量从80个变成12个,也就是多拦下68个。对一家年产值数亿的汽车供应链企业,后面连着整车厂的交付、召回和违约风险。
项目起点是一种新型铝合金压铸件的微裂纹。产线运行三个月,带标注的缺陷图只有100张。CNN或YOLO都能开训,但这么小的数据集很容易过拟合:验证集看着不错,换到现场就漏;阈值继续往下压,误报又迅速上来。
团队没有继续等缺陷自然积累。100张真实图被当作种子,后面接上生成、筛选和蒸馏三道工序,把候选样本池扩到1万张,最后再将能力压进轻量模型。
旋转和加噪,补不出一条新裂纹
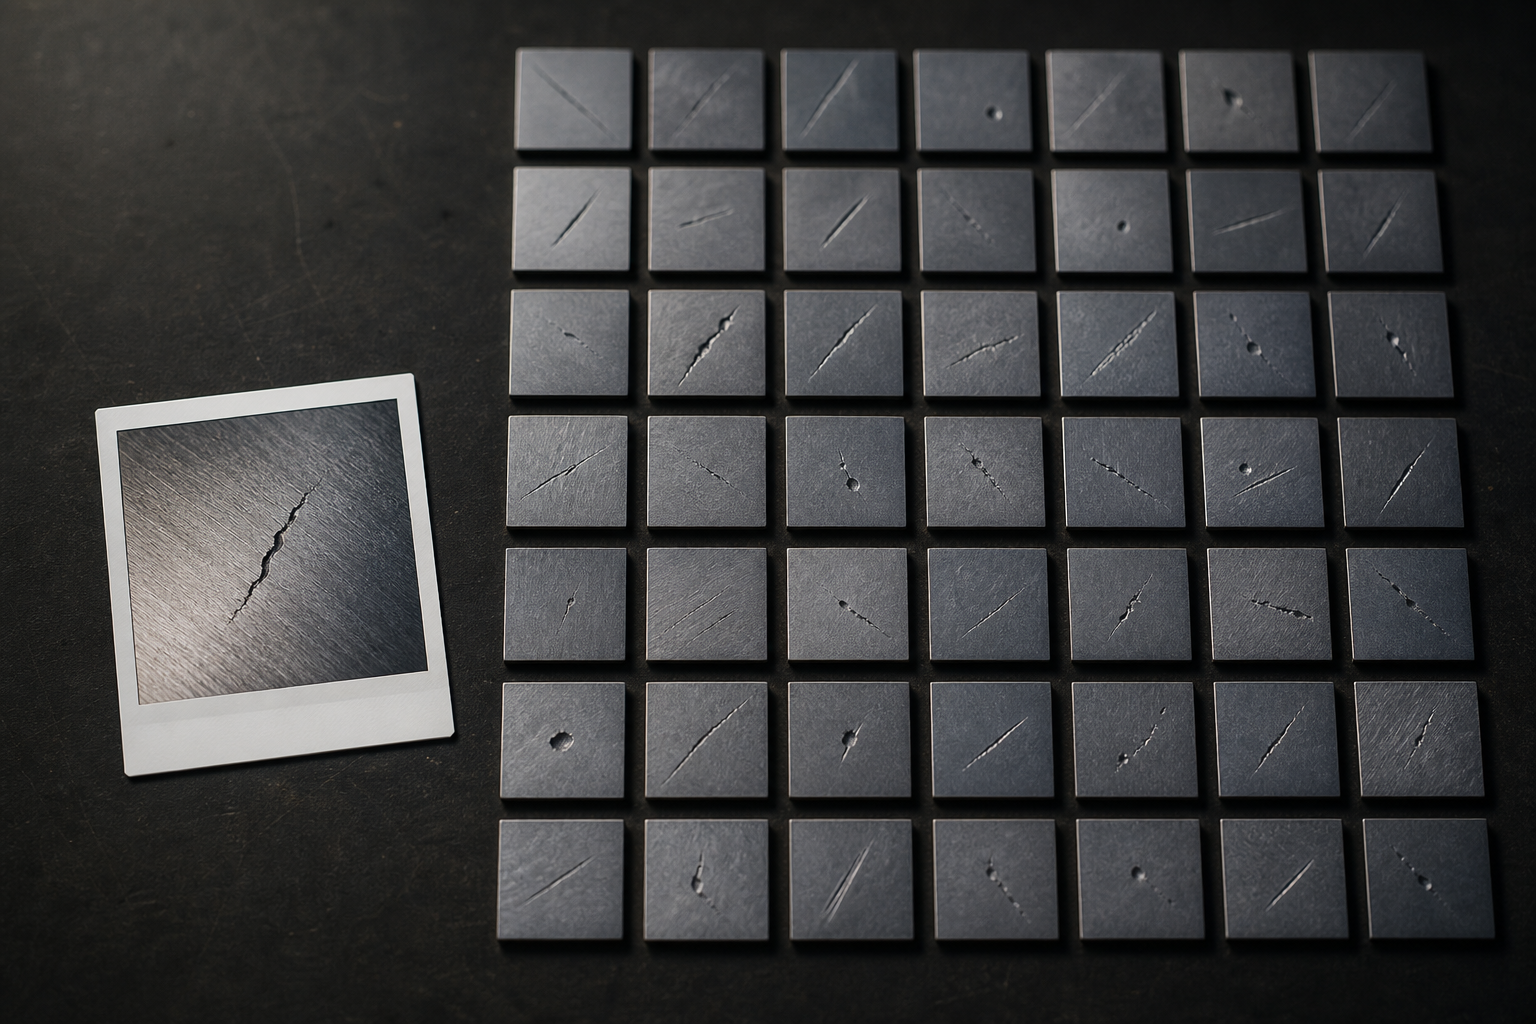
旋转、翻转、加噪仍然有用,但它们只是让同一张图换个姿态,不会增加新的缺陷形态。微裂纹样本真正缺少的,是位置、外观和表面纹理的变化。
这套方案使用了CLIP变体和潜扩散模型(Latent Diffusion Model)。第一步是把100张真实缺陷图与文字描述配对,例如“边缘细微线性裂纹”“表面点状氧化坑”。CLIP(Contrastive Language-Image Pre-training)把图像和文本放进同一个特征空间,让裂纹、氧化坑与正常表面之间有可比较的距离。
随后,团队用带ControlNet的扩散模型生成缺陷图。工程师先提供正常零件的掩码图(Mask),圈定缺陷出现的位置和形态,Prompt不再承担全部控制。潜空间经过微调后,系统生成了9,900张伪缺陷样本,光照和材质纹理尽量贴近真实产线。
一万张候选图,先删掉不像真的
合成图的问题也很具体:裂纹可能悬空,光影方向可能反了,表面还可能留下扩散模型特有的噪点。这样的图直接进入训练集,模型记住的可能是假线索。
100张真实图和9,900张合成图组成了1万张候选集。团队让一个量化后的视觉大模型担任“审计员”,逐张打分,检查缺陷位置、纹理和光影是否符合物理逻辑。约8,200张高保真样本通过筛选,进入后续训练。
样本池做到1万张只是中间步骤。真正决定效果的,是有多少图经得住筛查。
文本描述给模型多一把尺子
图片变多,只解决了数量问题。为了应对光照波动和零件摆放偏移,训练阶段还同时输入图像特征与缺陷文本描述。
遇到一块模糊阴影时,系统会在CLIP特征空间里寻找最接近的描述,判断它更像光照干扰,还是划痕、裂纹一类缺陷。这相当于在像素之外,又加了一层语义参照。
项目实测中,产线后来出现过一种样本集里没有的新型磕碰。多模态模型依据语义相似度给出了“疑似缺陷”预警,传统模型则将其判为正常。系统不需要输出一段长解释;能把陌生图案送进待复核队列,就已经有价值。
大模型留在训练端
实验室里能跑通视觉语言模型(VLM),不代表它能直接进产线。工业相机每秒拍摄5至10张高分辨率图,单张推理延迟要控制在100ms以内。
就算参考4-bit量化方案,让70B模型运行在32GB显存环境中,实时质检的显存和时延账仍然算不过来。团队最终选择了模型蒸馏。
教师模型是经过大规模工业数据集预训练的多模态大模型,负责提取特征并生成软标签(Soft Labels)。学生模型则采用轻量级ViT(Vision Transformer)或定制YOLO版本,在1万张增强样本上模仿教师模型的特征分布。
产线不需要直接运行教师模型。适配昇腾910C时,团队通过优化自定义算子,把学生模型的推理延迟压到42ms,低于100ms的预算。大模型继续留在训练和审计环节,实时检测交给轻量模型。
42ms之后,样本还得继续回流
最终实测中,微裂纹漏检率从8%降到1.2%,误检率维持在2%左右,推理延迟为42ms。
这组结果也改了团队对Scaling Law的看法。样本规模当然重要,但合成图的物理可信度会直接决定规模是否有用。微裂纹三个月才积累到100张,靠产线等待太慢;仿真(Simulation)和生成式AI承担的工作,是先补出可训练的缺陷变体。
它们也有边界。扩散模型可以扩展已知缺陷的外观,很难预见训练资料中毫无线索的新类型。现场一旦出现漏检,样本仍要回传到CLIP空间,重新生成、筛选并蒸馏。
人工标注没有被取消,这个项目也没有把十万张标注当作前置条件。团队先接通自动生成、自动审计、模型蒸馏和现场回传,再用新增的真实样本持续校正合成数据。模型架构以后可以替换,这条数据管线不能断。