很多 Agent 在多步任务里出错时,开发者会继续往 System Prompt 里加要求:严格输出 JSON、不要解释、先调用 API 再汇总、最后检查一遍。短期可能有效,但如果错误一会儿出在字段解析,一会儿出在调用顺序,Prompt 很快就会变成一份补丁清单。
“请一步步思考”能影响这一次的回答方式,却不一定能把某条规则变成稳定行为。GRPO 针对的是后一个问题:训练时让模型为同一道题给出多条回答,再根据得分差异更新参数。开发者不再只修改措辞,还要明确什么算对。
GRPO 省掉了 Critic,但没省掉评分
PPO 通常需要一个 Critic,也就是用于估计状态价值的评论家网络。放到大模型后训练里,这会多出一套需要维护和计算的网络。DeepSeek 使用的 GRPO(Group Relative Policy Optimization,群体相对策略优化)去掉了 Critic,改用同一组回答之间的相对得分作为更新依据,从而简化流程并降低相关计算开销。
它的工作方式并不绕:
- 给模型同一个问题,生成一组回答,例如 5 个;
- 用规则评分器或 Reward Model 给每个回答打分;
- 比较每个回答与组内平均分的差距;
- 用相对优势更新模型策略。
若回答 i 的得分是 R_i,组内平均分是 R̄,常见的归一化写法是:
A_i = (R_i - R̄) / σ
得分高于组内平均水平,优势值为正;低于平均水平,优势值为负。GRPO 不需要先预测一个绝对价值,而是比较同一道题下谁做得更好。
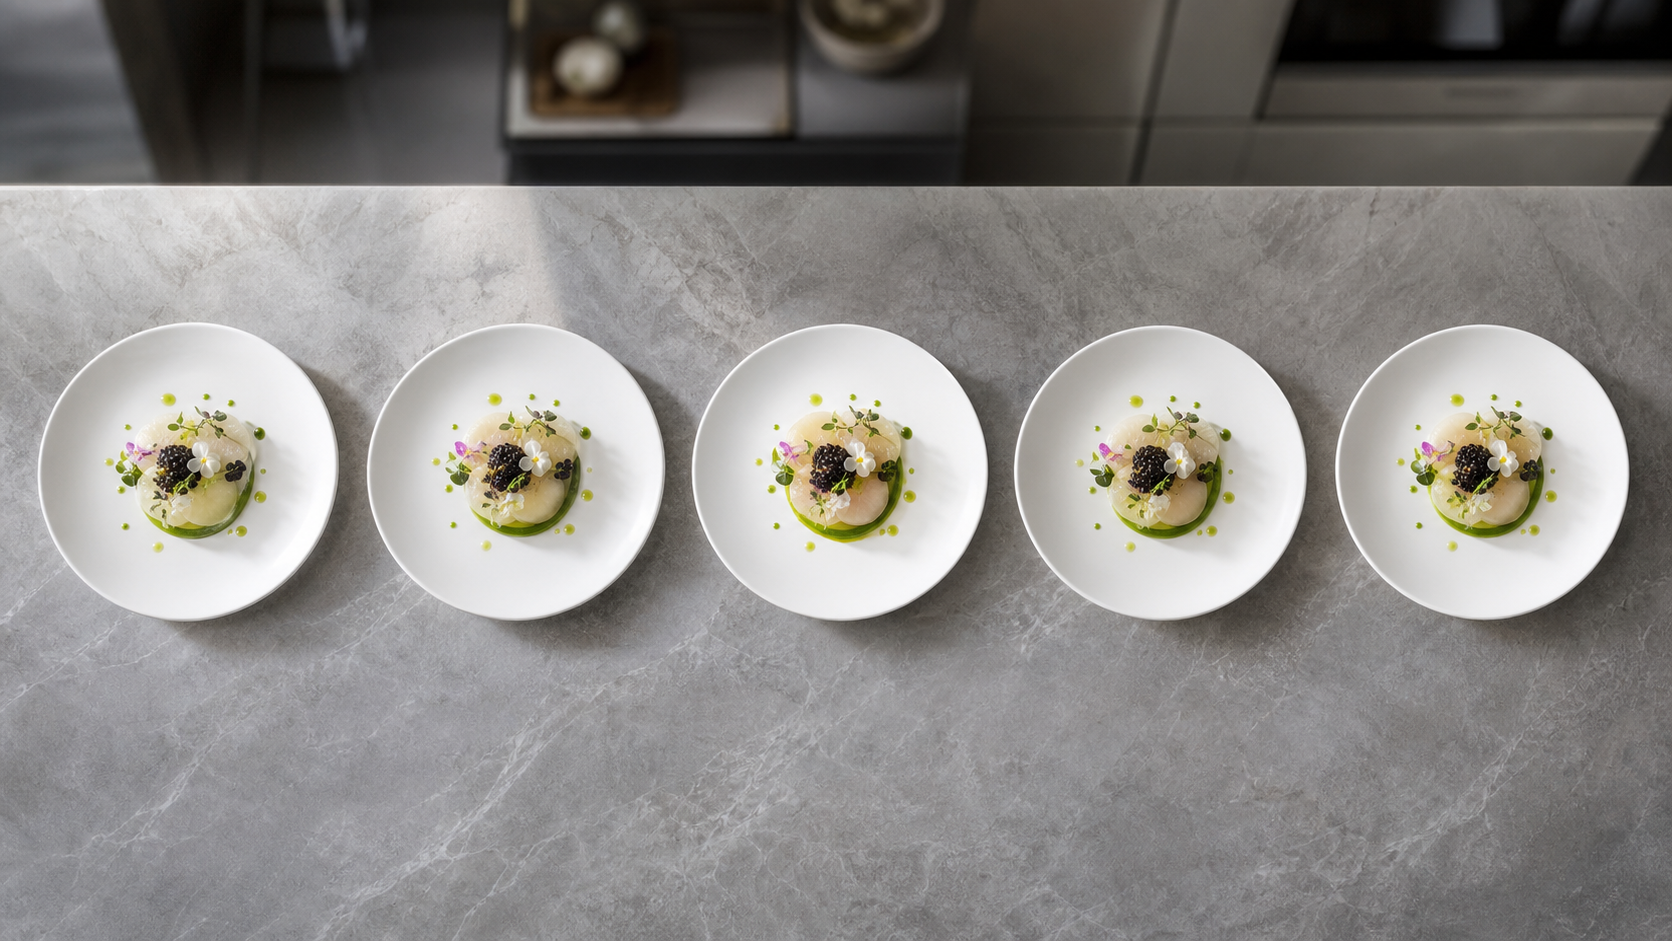
换成做菜的比喻:没有 Critic 助手,只有负责打分的顾问。一次做 5 道菜,顾问逐个评分,再根据它们与平均分的差距调整做法。
把“要求模型”改成“验收结果”
假设一个 Agent 要完成“调用 API → 解析结果 → 汇总报告”。常见做法是在 Prompt 里反复强调:必须输出 JSON,字段不能缺失,不要添加解释。
GRPO 的做法是把这些要求写成可以执行的检查项。例如:
- 输出能被解析为 JSON,记
+1;无法解析,记-1; - 字段与 API 返回值完全匹配,再记
+2; - 答案正确,且业务要求的可见推理链不超过 500 字,再记
+0.5。
这些分值只是示意,不是可以直接照抄的配方。重点在于奖励顺序:正确性优先,格式和长度只能作为辅助条件。否则,模型可能学会输出漂亮的 JSON,却没有填对任何字段。
能用程序判定的任务,尽量先用规则评分。编译器结果、单元测试、正则匹配和数据库查询结果都可以成为硬性奖励。简洁度、表达方式或是否包含 <thought> 标签,更适合放在较低权重的位置。既然结果能够直接验证,就没必要先让另一个模型凭感觉打分。
先跑通一个小闭环
不要一开始就训练一个什么都做的 Agent。先选一个边界清楚的任务,例如 API 结果解析、SQL 生成或代码修改,并准备好对应的检查器。
一个最小训练环路可以写成下面这样:
responses = sample(prompt, n=5)
scores = [reward_fn(r) for r in responses]
advantages = group_normalize(scores)
update_policy(responses, advantages)
这里最费心的通常不是四行流程,而是 reward_fn。它必须能够区分“格式正确但答案错误”“结果正确但过程冗长”以及“结果与格式都正确”等不同情况。
每轮训练后,也要检查高分回答是否真的符合业务目标。如果错误答案持续拿到高分,先改评分规则,而不是继续增加训练轮次。
智源社区收录的 Andriy Burkov 教程以 Qwen2.5-1.5B-Instruct 搭建了分布式 GRPO 流程。这说明 GRPO 已经有具体的工程实现可以参考,但不能据此推断任意小模型都会自动获得强推理能力。模型能学到什么,仍取决于任务、样本和奖励规则。
高分不等于学对了
GRPO 最常见的问题不是模型不学习,而是模型学会了“刷分”,也就是奖励作弊。
如果“推理步骤越多”得分越高,模型可能输出大量重复内容,制造出认真思考的样子;如果只检查 JSON 是否可解析,它可能交出结构合法但数据错误的结果;如果 <thought> 标签本身能加分,它也可能只学会稳定地输出标签。
因此,奖励函数首先要锁定最终结果。单元测试是否通过、字段是否匹配、查询结果是否正确,这些条件应排在前面。格式、长度和过程说明只能在结果正确的前提下加分。
哪些任务值得用 GRPO
不是每个 Agent 问题都需要训练。如果故障只是偶尔漏一个字段,运行时的 Schema 校验、重试或工作流约束可能已经够用。
更适合 GRPO 的任务通常有三个特征:同类任务会重复出现,结果可以自动判定,而且错误无法只靠一句 Prompt 稳定修复。代码能否编译、SQL 结果是否正确、API 字段是否一致,都比开放式表达更容易建立可靠奖励。
Prompt 仍然负责告诉模型当前要做什么,工作流负责控制工具和步骤,GRPO 则把反复出现的行为偏好写进模型参数。三者不是替代关系。
所以,“请一步步思考”不必从 Prompt 里彻底删除,但别把它当作修复逻辑的开关。先把一句要求改成一条可执行的检查规则。只要同一道题的多条回答能够拉开分数,模型才有明确的学习信号。