 AI 实操指南
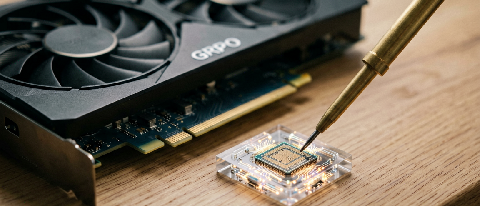
用GRPO算法调教3B小模型:不走SFT弯路的企业专属微调方案
告别繁琐SFT与昂贵的Critic模型,利用GRPO(群组相对策略优化)在单卡RTX 4090上对3B参数模型进行强化学习微调。本文提供具体的奖励函数编写模板、显存控制参数及实战流程,帮助中小团队以最低成本实现垂直领域的
阅读全文关键词:奖励函数
AI 实操指南
告别繁琐SFT与昂贵的Critic模型,利用GRPO(群组相对策略优化)在单卡RTX 4090上对3B参数模型进行强化学习微调。本文提供具体的奖励函数编写模板、显存控制参数及实战流程,帮助中小团队以最低成本实现垂直领域的
阅读全文 AI 实操指南
当 Agent 在多步任务里反复跑偏,继续加“请一步步思考”往往只能改变当次输出。GRPO 去掉 Critic,用同题多回答的相对得分更新模型,把优化重点移到可验证的奖励规则。
阅读全文G1的受扰恢复演示能说明动作结果,却不能反推出奖励函数、域随机化或RL代码占比。结合公开资料,更值得关注的是实时控制、Sim2Real及任务中的连续稳定性。
阅读全文