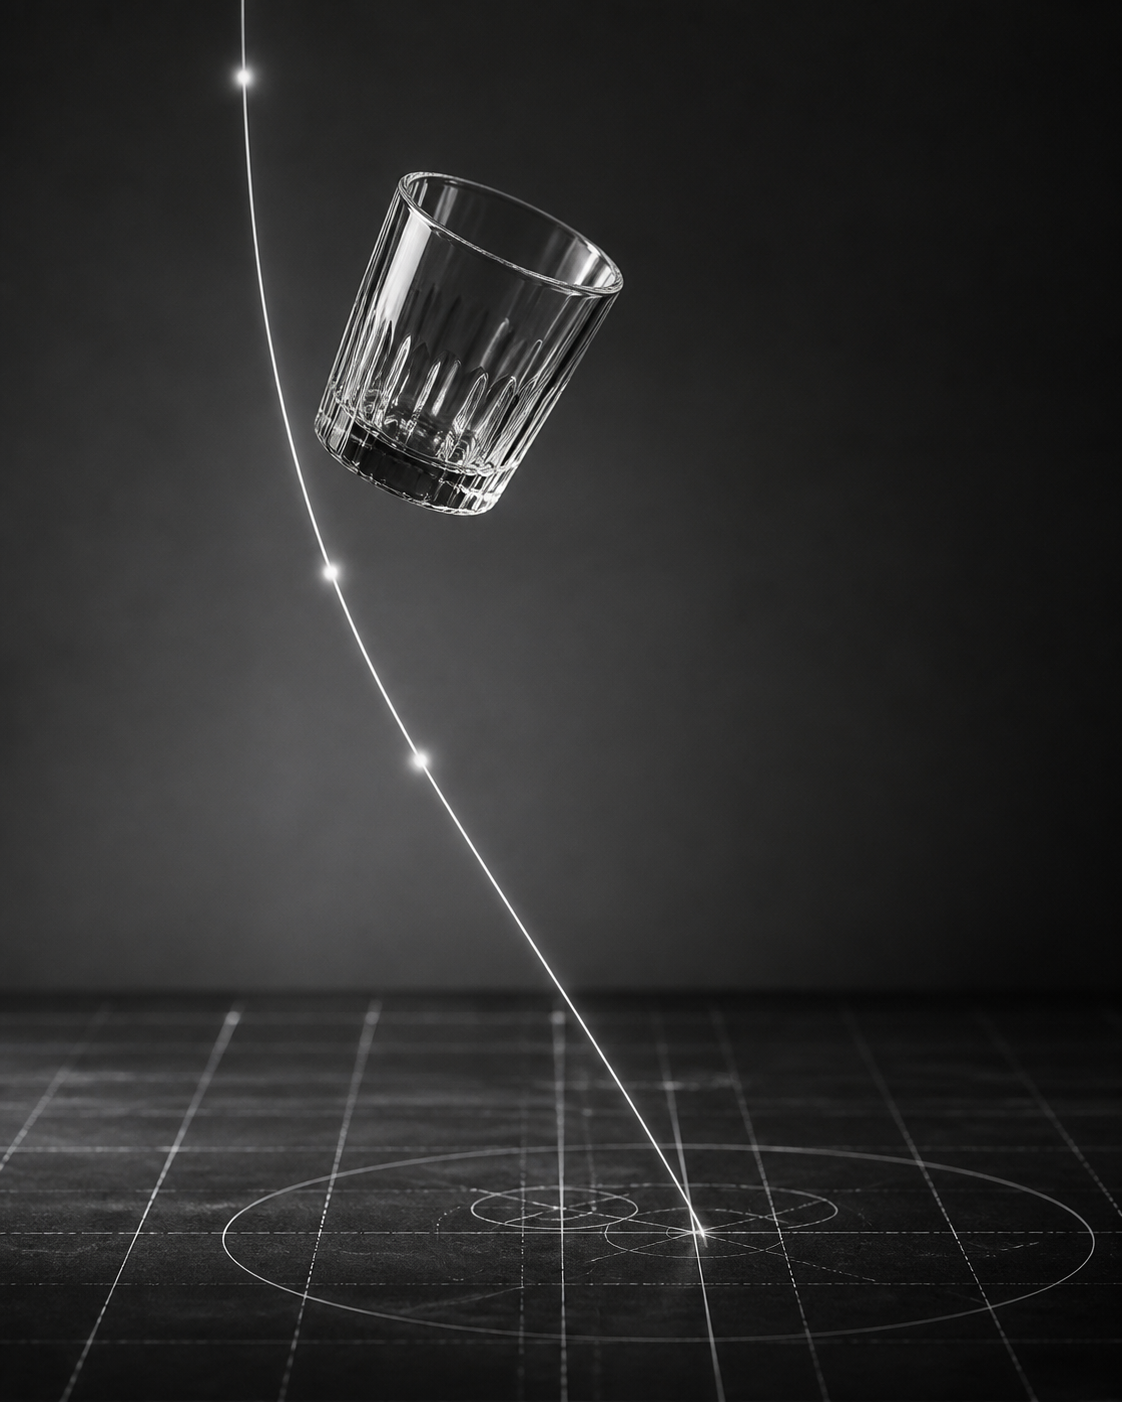
玻璃杯从桌边滑落。人会预期它持续加速,撞上地面后碎裂、滚动或反弹,但不会穿过地板。视频模型给出的结果却可能是杯壁突然变软、落点漂移,甚至直接跳过碰撞。
这类错误通常被称为“物理幻觉”。Sora 3 等模型可以把材质、镜头和光影做得很像真实拍摄,但画面逼真不等于运动正确。北京大学人工智能研究院在 2026 年 2 月 12 日发布的文章提到,物体穿透、重力失效和碰撞逻辑混乱仍频繁出现,原因之一是视频模型大多还在拟合视觉表面。
看起来像重力,和真正按重力运动,是两件事。
对一条短广告来说,偶发的反弹失真或许还能通过选片和剪辑避开。到了数字孪生、自动驾驶仿真或电影制作环节,错误轨迹就不再是小瑕疵,而会直接削弱结果的可信度。
NewtonRewards 给训练加了一把物理尺子
继续增加视频样本,未必能让模型自动学会刚性的物理规律。石溪大学团队开发的 NewtonRewards,提供了另一种办法。
据科技行者 2026 年 1 月的报道,NewtonRewards 会提取视频中的运动轨迹和物体特征,将它们作为物理量的代理,再用恒加速度等约束检查运动是否合理。球体下落时,位置、时间、初速度和重力加速度需要相互对应;轨迹偏离这些关系,训练阶段就会收到相应的反馈。
它改变的不是画面风格,而是模型判断“什么运动更合理”的标准。模型不能只追求前后帧顺滑,还要为不符合物理规律的轨迹付出代价。
不过,NewtonRewards 并不等于一套完整的物理引擎。它主要把牛顿力学写进训练信号,并没有直接接管刚体碰撞、流体或复杂材质的仿真。把物理规律加入奖励函数,与把 UE6 原生集成到扩散模型底层,也不是同一件事。现有素材能够支持前一种说法,后一种更适合作为工程设想,而不是已经落地的产品事实。
物理引擎不负责画面,它负责把轨迹钉住
APIMart 对物理视频生成架构的梳理将相关系统拆成三个部分:习得的世界模型、物理引导的训练,以及仿真在环。
世界模型负责表示或预测物体的位置、速度、材质等状态;NewtonRewards 这类方法在训练阶段加入物理偏好;仿真在环则把物理引擎直接接入工作流,让它先计算运动,再由生成模型完成视觉呈现。
传统链路通常可以写成:
Prompt → 扩散模型 → 视频
加入仿真后,链路可能变成:
Prompt → 物理仿真或约束 → 运动与几何骨架 → 扩散模型补充材质和光影 → 视频
以 Unreal Engine 或 NVIDIA Omniverse 这类平台为例,仿真层可以负责碰撞、刚体和流体计算,扩散模型则处理材质、纹理与光影。杯子怎么掉,不再完全交给模型猜测;生成模型拿到的是一条已经计算过的运动轨迹。
这能降低穿模概率,但“从底层杜绝”仍然是过强的说法。碰撞体设置错误,或者最终画面没有严格贴合几何骨架,物理错误依然可能出现。物理引擎提供的是更可靠的参照,不是自动正确的保证。
还有一个容易被忽略的问题:物理引擎只会根据输入参数计算。一个杯子究竟是玻璃、塑料还是橡胶,需要世界模型先作出判断。属性判断错了,仿真结果只会“精确地错”。这也是世界模型、训练约束和物理引擎需要配合的原因。
真正有用的变化,是结果开始可控
纯 Prompt 工作流里,想让一个球“弹得更高一点”,通常只能修改描述,再等待随机生成结果。接入仿真层后,重力加速度 g、反弹系数 e 等参数可以直接调整。指令从模糊的语言要求,变成了明确的物理变量。
长程一致性也有机会得到改善。物理层可以持续保存坐标、碰撞关系和刚体状态,减少物体随画面推进而变形、漂移或突然改变运动方式。最终视频能否严格服从这些状态,仍取决于生成模型对物理骨架的遵循程度。
对工业用户而言,可重复比“偶尔生成得很真”更重要。同一组初始条件能否得到稳定轨迹,参数变化能否清楚反映在结果中,决定了视频模型能不能进入仿真和测试环节。
多一道仿真,也多一笔计算成本
生成链路加入物理仿真后,计算量和系统复杂度都会上升。系统既要快速生成运动骨架,也要让扩散模型及时完成渲染。若目标是端侧实时运行,芯片还要同时承担模型推理和物理仿真算子。
物理层与生成层之间也必须保持同步。摄像机变化、遮挡关系和物体状态如果没有准确传递,前面算对的轨迹,可能在最后的画面里再次走样。
所以,视频 AI 暂时还没有告别“幻觉”。更准确的说法是,它正在从单纯拟合像素,转向同时接受物理规则和仿真结果的约束。NewtonRewards 已经给出了一种具体做法,仿真在环则提供了更完整、也更昂贵的工程路线。
艺术生成追求“看起来成立”,仿真生成要求“计算上说得通”。杯子能不能老老实实落到地面,看似只是一个小测试,实际决定了视频模型能否从会拍画面,走到会计算世界。