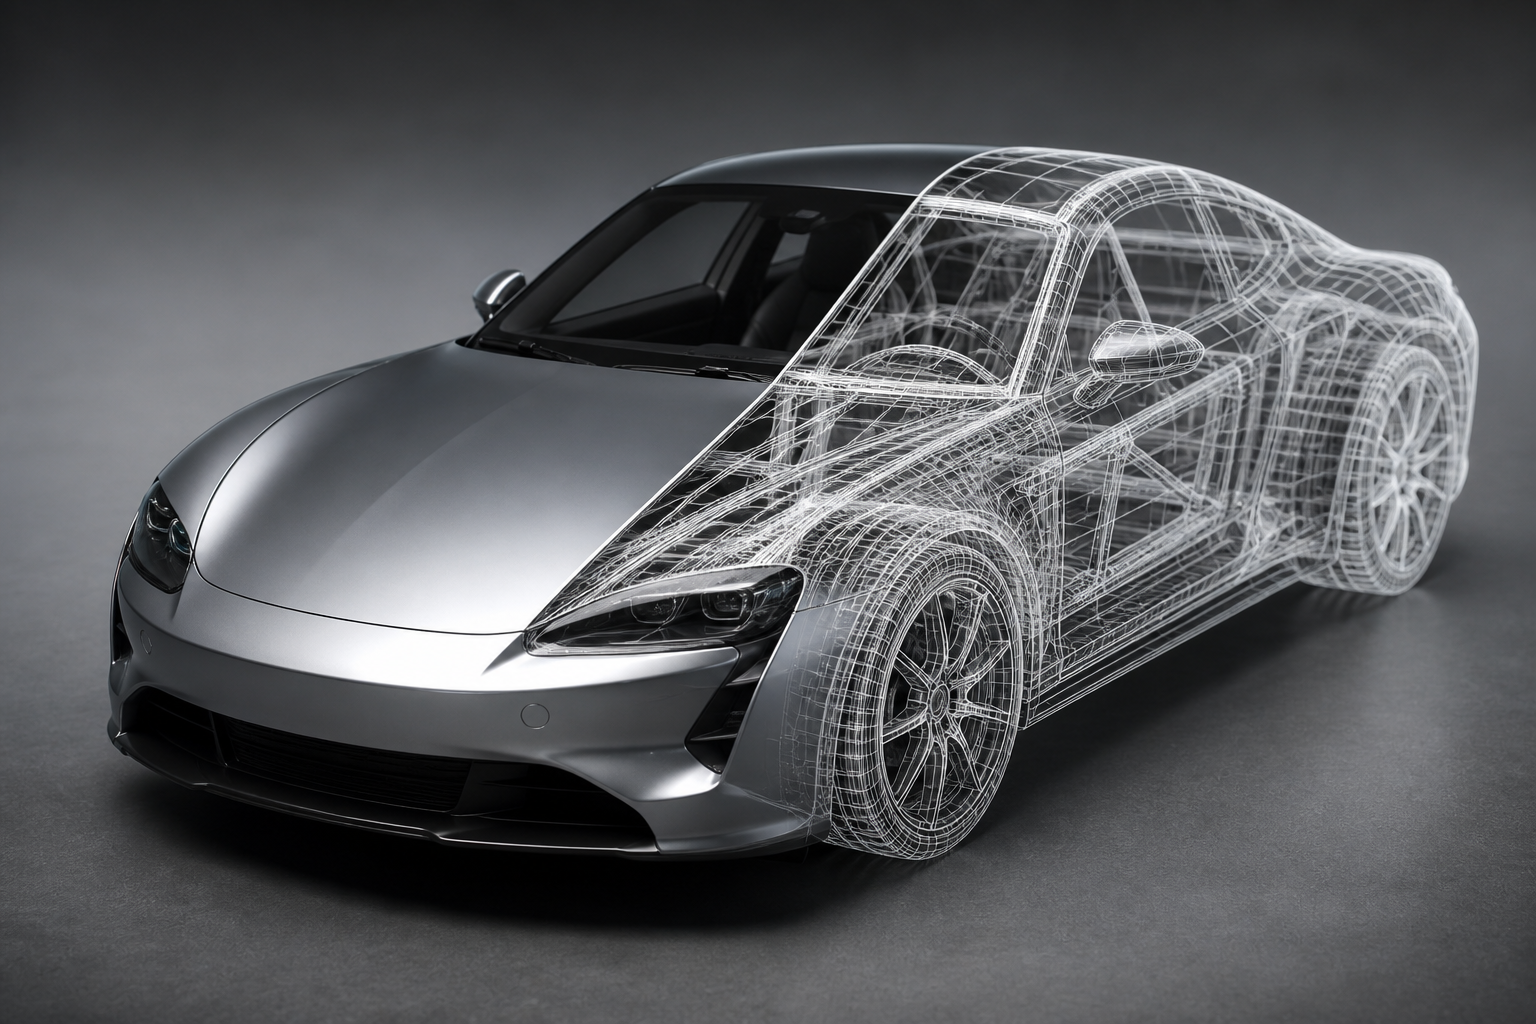
一辆汽车从镜头前驶过,车身、路面和光影都很自然。轮胎被遮住后,问模型一句:它现在在哪里?画面越漂亮,这个问题越刺眼。
《全面解析“世界模型”:定义、路线、实践与AGI的更近一步》举的就是这个例子。视频给出的解释是:Sora没有构建一辆车的3D几何模型,学到的主要是像素组合的概率分布。画面可以保持连续,遮挡后的空间关系却未必被完整保留下来。
OpenAI发布Sora时曾将其称为“世界模拟器”。虎嗅对世界模型的梳理将Sora归入视频生成路线:模型让画面中的事物沿时间连续演化,已经超过逐张拼接静态图像的做法。但上海科学技术情报研究所的相关文章也提到,视频模型仍会生成实体突然消失、运动违反重力规则等内容。
视觉连续性和物理一致性,仍是两道不同的测试。这也是Sora能否算“世界模型”持续引发争论的原因。
交互把问题从下一帧推到下一状态
上海科学技术情报研究所的文章用了一个很形象的区分:Sora更接近“播放一个世界”,Google DeepMind的Genie 3则开始“探索一个世界”。Genie 3可以根据提示实时生成供人类或智能体探索的虚拟环境,重点落在实时交互和长时间一致性上。
预渲染视频主要回答下一帧会是什么样。进入交互环境后,模型还要不断处理另一个问题:用户采取动作,场景接下来会怎样变化?这个过程可以写成一条简单的关系:观察 + 动作 → 下一状态。
实时交互本身不能证明模型已经掌握重力、碰撞或物体恒常性。它带来的变化是,模型开始接受连续动作的检验。用户每一次转向、移动和改变视角,都在追问环境内部是否存在稳定状态。原本藏在一段视频里的几何错误,也会更快暴露。
World Labs先补空间骨架
李飞飞领导创建的World Labs选择了3D空间生成。按照现有公开介绍,电影级连续性并非它的首要目标,物体在哪里、空间是什么形状,才是更优先的问题。
这条路线正面处理了“被挡住的轮胎”难题。模型需要保留完整车辆及其空间关系,轮胎不会因为离开画面就从内部表征中消失。相比从连续像素中反推几何结构,显式3D建模给了空间关系更直接的落点。
不过,一张稳定的3D空间图还没有覆盖全部物理问题。知道枕头在哪里,不代表知道它受力后如何变形;记住物体的位置,也不等于能预测碰撞后的运动。空间智能先处理“在哪里”,动力学还要回答“受力后怎么动”。
NGFF把力写进生成链路
北京大学人工智能研究院介绍的NGFF提供了另一种办法:用显式力场连接视觉感知和物理推理,把动力学规律转化为可解释、可干预的中间表征。
据北大介绍,在多个设置下,NGFF的物理一致性显著超过Veo3、NVIDIA Cosmos等视频模型,推理速度相比传统物理模拟提升两个数量级。公开展示的交互结果包括在外力作用下提起枕头,以及拖拽衣服后的动态变化。这里真正要看的,是画面能否随着外力产生合理、连续的反馈。
“两个数量级”说明NGFF与传统物理模拟之间存在明显的速度差距,但还不足以据此断言它已经能在所有端侧设备上实时运行。更稳妥的判断是,显式力场展示了一种中间方案:生成模型可以保留部分物理约束,同时避开完整物理仿真的全部计算负担。
物理直觉要经得住行动
AGI的物理直觉不必复刻一个完美的物理引擎。人也不会先列出重力方程,才判断失去支撑的杯子会掉下去。对智能体来说,预测可以近似,但必须对行动有用。
更可操作的检验方式是:遮挡发生后,模型仍能保留物体及其空间关系;动作执行前,它能及时预测环境的下一状态;结果偏离预期时,它会根据新的感知反馈修正判断。
这套能力放在人形机器人上尤其直观。生成视频里,实体短暂消失可能只是一处瑕疵;机器人在现实环境中行动时,同样的状态判断错误会影响避障、移动和抓取。世界模型需要在动作发生前完成一次内部推演,接触环境后再用反馈校正。
Sora、Genie 3、World Labs和NGFF解决的是不同层次的问题,暂时不能排成一条简单的升级链:Sora推进了时间连续的视频生成,Genie 3把交互加入环境,World Labs强调3D空间结构,NGFF尝试把力和动力学写入生成过程。
这些进展还不能直接等同于AGI。更准确的说法是,世界模型正在把“物理直觉”拆成可以检验的问题:被挡住的轮胎还在不在?采取一个动作后,环境会怎样变化?预测错了,模型能不能及时改正?
当这些问题都能得到稳定回答,AI才算从生成一段像真的画面,走向在世界中预测和行动。