上周在苏黎世的一场闭门技术研讨会上,一位头部云服务商的硬件架构师递给我一张纸条,上面写着:"别听 PPT,看延迟。"
这话说的是当下量子计算与 AI 结合的真实状态。2026 年,多个实验室的物理量子比特数突破 1000,IBM Quantum、Google Quantum AI 以及国内几家头部初创公司,都宣布把量子处理器作为协处理器接入经典 AI 训练链路。消息铺天盖地,仿佛"量子霸权"要立刻重塑算力格局。
但工程现场比发布会骨感得多。
量子不是来抢 GPU 的活,是来"插队"的
要理解为什么要谈量子-经典混合算力,先得看清经典 AI 的瓶颈。Transformer 架构成为 NLP 主流之后,大模型参数量几乎呈指数级增长。我们在《GPT-5o 之后,企业 AI 预算怎么花才不浪费》里讨论过:算力成本不是线性往上走,而是被内存墙和互连带宽双向挤压。到了 2026 年中,单纯堆 GPU 集群训万亿参数模型,边际收益已经很低。
量子计算切入的角度,并不是做矩阵乘法——那是 GPU 的强项,而且量子门电路的错误率目前撑不起大规模浮点运算。量子机被定位成一个特定的"优化器"。
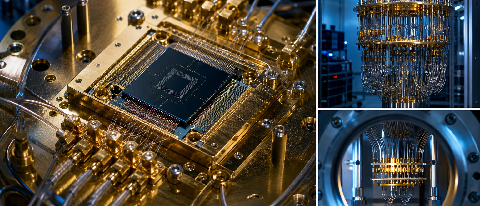
混合架构典型的工作流:经典神经网络负责特征提取和非线性映射,这部分仍由 NVIDIA H200 系列或国产昇腾 910C 承担;当模型进入损失函数最小化阶段,或撞上组合优化(变量空间指数级爆炸)这类问题时,梯度信息被传给量子处理器。量子比特利用叠加态快速搜索最优解或局部极小值,再把结果回传给经典系统。
分工听起来漂亮。问题是数据在经典服务器和量子机房之间来回跑,延迟经常把量子端的理论优势抹平。这就是那位架构师强调"看延迟"的原因。现在用光互联缩短物理距离,端到端延迟从毫秒级压到微秒级——但微秒级依然是个严峻的工程约束。
药物研发:目前唯一能吃的甜点
那么哪里真的能用上?答案是药物分子模拟和物流组合优化。
经典 AI 训练擅长处理结构化数据或文本图像。量子化学模拟不一样,分子的电子结构本质上是量子多体问题,经典计算机要用高精度算法解薛定谔方程,开销巨大。量子计算机本身就是量子系统,模拟分子相互作用有天然优势。
IBM Quantum 在 2026 年 5 月发布的测试数据显示,用 127 量子比特处理器跑某种特定抗癌分子的路径优化模拟,混合算法比纯经典模拟快约 40 倍。数字很亮眼,但前提是特定小分子结构,且要在极低温环境下运行。换到通用 NLP 任务,量子加速几乎可以忽略不计。
这也解释了为什么 Suno、美团这类公司目前没大规模接量子计算。美团在《外卖算法变了》里提过,其调度核心是数百万实时并发请求,要的是高吞吐和低延迟,不是指数级搜索空间。这种场景下,专用 ASIC 或 FPGA 比量子比特靠谱得多。
噪声和纠错,是悬在头上的硬约束
前景诱人,但拦在量子计算大规模商用前面的,还是噪声和纠错。
现在的量子处理器大多还停在 NISQ(含噪声中等规模量子)阶段。量子比特极脆弱,环境温度波动或电磁干扰都会引发退相干、产生错误。要纠错,就得引入大量冗余量子比特做编码。
2024 年,纠错大约需要 1000 个物理比特保护 1 个逻辑比特。到 2026 年,这个比例虽然有改善,但依然高得吓人。要稳定支撑大型 AI 模型优化,可能需要数百万甚至上亿物理量子比特——而全球最好的实验室,物理比特数刚突破千位。
再加上量子态不可克隆定理,经典数据那种简单地备份、重试的思路走不通。量子态一旦出错就坍缩,前功尽弃。这意味着每一次量子操作都得近乎完美,对控制电子学和低温系统提出了苛刻要求。
算力新范式的前夜,不是清晨
回到开头的问题:AI 训练瓶颈被打破了吗?
没有。量子-经典混合算力没有带来颠覆性的、普适性的性能飞跃。它更像一支针对特定问题的"特种部队",在药物发现、金融风控组合优化等狭窄领域展示了潜力,远远撼动不了经典 AI 训练的主导地位。
当前的市场热度,很大一部分来自资本对下一代技术浪潮的预期,而不是当下的实际产出。对大多数 AI 开发者和企业来说,更该关注的是怎么优化经典硬件利用率、怎么压低推理成本。我们在《3B 模型打赢 70B 的秘密》里看到,端侧小模型的崛起才是当下更务实的选择。
量子计算是一场马拉松。2026 年的这些混合架构原型,更像赛道上的第一个补给站,证明方向没错,也清晰地标出前方还有漫长的荒原要跨。
在那之前,保持冷静。在算力这件事上,不能降延迟、不能省成本的"新范式",终究只是一场昂贵的技术表演。