盘古气象接入WRF:极端天气预报的混合解法
中国气象科学研究院将Pangu-Weather与WRF-ARW区域模式结合,用AI全球预报驱动区域精细化计算。公开材料并不支持笼统的“准确率提升30%”,更值得关注的是这套方法如何用于极端降水和台风强度预报。
阅读全文关键词:准确率
中国气象科学研究院将Pangu-Weather与WRF-ARW区域模式结合,用AI全球预报驱动区域精细化计算。公开材料并不支持笼统的“准确率提升30%”,更值得关注的是这套方法如何用于极端降水和台风强度预报。
阅读全文 技术应用
基于同一套儿童问答脚本,对2026年暑期上市的7款主流AI玩具进行多模态交互实测。重点比较响应准确率、端到端延迟、安全过滤和隐私边界,并给出家长可复现的选购清单。
阅读全文2026年,AI合同审查准确率普遍在85%-93%,但对非标条款的漏检率仍超10%。本文选取金杜、中伦、君合三家律所的真实案例,拆解误判率分布与人工复核机制,揭示当前LegalTech Agent的技术边界——准确不是终
阅读全文基于深圳、北京等地2025-2026年AI辅助行政审批试点数据,对比人工与AI在材料审核、流程处理上的时长与差错率,实测显示公文修正准确率超95%、审核时间缩短90%。同时揭示算法偏见、责任归属等行政伦理争议,专家建议建
阅读全文 前沿研究
基于2026年7月内测信息,Cursor V5引入多模态输入,允许开发者直接输入截图、设计稿生成代码。实际案例显示,简单UI还原准确率可达92%,但复杂交互仍需人工校验。本文拆解‘看图写码’的工作流改变与工程局限。
阅读全文 技术应用
2026年上半年金融、电商、出行三大行业的日志显示,客服Agent情绪识别准确率远低于宣传的95%。本文拆解幻觉、违规与误判背后的三大根源:训练语料的静态偏差、多模态模型的实时延迟、以及决策流程中权限与情绪的冲突。
阅读全文协和·太初罕见病大模型2025年2月进入临床后,真正难点不是识别准确率本身,而是跨医院、跨药名库、跨电子处方系统的复制能力。本文拆解不同医院部署时的真实阻力、合规边界与成本账本。
阅读全文2026年中,北京协和医院“协和·太初”罕见病大模型深入门诊预问诊一线。实测发现,在面对17种罕见药名时,标准输入下F1值可达0.96,但方言和错别字会导致准确率显著下滑。在DeepRare等竞品入局的背景下,医疗AI正
阅读全文切入企业财务自动化这一高频场景,专门解决多模态Agent在处理手写、模糊、折叠票据时的常见失败案例。提供具体的Prompt优化技巧和后处理校验逻辑,展示如何通过增加人工复核节点来提升最终准确率,极具实战参考价值。
阅读全文入夏以来台风外围高温叠加用电高峰,国家电网在厦门、杭州的调度大厅把AI调度员推到一线。配网AI智能体把故障定位压缩至16分钟,负荷预测准确率99%以上。结合央视、新华社公开材料,拆解AI调度如何替代人工盯盘,以及这套系统
阅读全文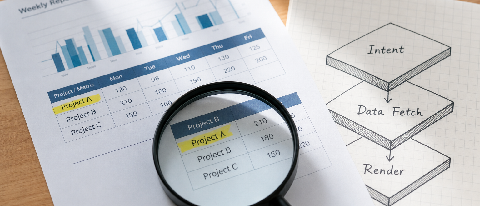 AI 实操指南
MCP 接进飞书三个月,自动周报仍卡在七成准确率。本文把故障拆成意图识别、数据拉取、模板渲染三层,逐项给出可落地的诊断与改造建议,并解释为什么关键判断必须留给人。
阅读全文 AI 实操指南
工作流跑通后,自动周报仍会漏日程、认错项目、写乱格式。问题不只在模型,而是工具可见范围、字段语义和渲染规则没有对齐。三个月的调整表明,MCP 适合负责调用,关键判断仍需明确约束和人工确认。
阅读全文