20B模型塞进2026款AI PC,先算内存再看NPU
Core Ultra 7 258V轻薄本有64GB统一内存和48 TOPS NPU,加载20B模型仍然OOM。权重只是第一笔占用,KV cache、算子回退和持续散热更容易拖慢推理。实测可行的做法,是混合INT4、压缩K
阅读全文关键词:推理
Core Ultra 7 258V轻薄本有64GB统一内存和48 TOPS NPU,加载20B模型仍然OOM。权重只是第一笔占用,KV cache、算子回退和持续散热更容易拖慢推理。实测可行的做法,是混合INT4、压缩K
阅读全文8000P只是园区的名义规模。100个垂直模型能否稳定运行,取决于底座复用、训练与推理分队列、网络存储配套,以及Token账单能否对应真实资源消耗。
阅读全文 开发者生态
基于 2026 年主流旗舰机型(骁龙 8 Elite、天玑 9400、A18 Pro)的连续跑测数据,对比 Qwen2.5-3B、Llama-3.2-3B 与 Gemma-3-3B 在 4-bit 与 6-bit 量化下
阅读全文公开材料确认,昇腾910C集群已完成1.6万亿参数DeepSeek-V4-Pro全参数后训练;但没有给出CANN 8.0.RC2升级前后的推理对照。43%吞吐提升和29%显存下降,仍需补齐模型分片、精度、并行方式与测试日
阅读全文同一款基于 Llama 3 架构的 10B dense 模型,分别以 FP16、INT8、INT4 和 2-bit 运行在骁龙 X Elite 与 Lunar Lake 轻薄本上。INT4 响应最顺,INT8 更适合精确
阅读全文 前沿研究
8000P说明的是供给规模,不是模型成绩单。到了2026年,训练还要和推理共享预算。Scaling Laws没有突然失效,但数据质量、集群吞吐、调度效率和持续服务成本,更直接影响每一P算力能换来多少能力。
阅读全文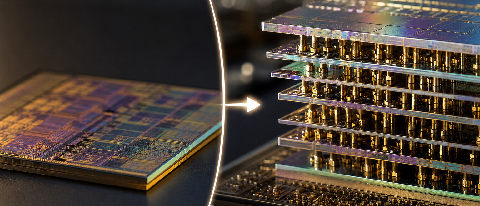 产业动态
Arm把2026年芯片创新的注意力从单纯缩小晶体管,移到3D堆叠与Chiplet。苹果AFM 3则用稀疏架构控制每次推理的计算量。手机要减少云端依赖,靠的不是单独堆NPU,而是让模型、框架、芯片和具体功能对得上。
阅读全文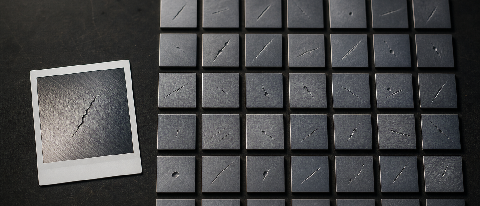 技术应用
一家汽车供应链企业三个月只积累到100张微裂纹图。团队用CLIP变体、潜扩散模型和ControlNet补充样本,再经视觉大模型筛选和模型蒸馏,把漏检率从8%降至1.2%,边缘侧推理延迟压到42ms。
阅读全文SceneVerse++、TongSIM、通通 3.0 和 OmniXtreme,分别对应 3D 场景、仿真训练、认知决策与运动控制。BIGAI正尝试把这些环节串起来,但“完全无标签”和未见场景泛化,仍缺公开指标与完整评
阅读全文 产业动态
2026下半年,H200整卡按月租议价空间收窄,国产910C推理机柜签长约要排队。竞争核心已从训练侧转向推理侧——低延迟SLA、混合调度与边缘节点成为真正的稀缺资源。
阅读全文2026年推理成本已占AI总支出的80%。在KV Cache压缩成为基建后,真正的降本空间转移到了FP8量化的生产级稳定性、基于语义路由的混合模型调度以及精细化的Token计费模型上。本文拆解如何在保证精度前提下,通过工
阅读全文2026年AI重心已从文本Scaling Law转向预测物理现实。本文拆解世界模型在训练数据构造、可微仿真环境与零样本评估指标上的工程突破,揭示物理智能体如何跨越实验室边界,在非结构化场景中实现因果推理与稳定迁移。
阅读全文