 技术应用
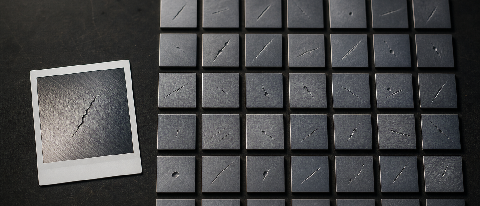
三个月只攒100张缺陷图,怎么补到1万张
一家汽车供应链企业三个月只积累到100张微裂纹图。团队用CLIP变体、潜扩散模型和ControlNet补充样本,再经视觉大模型筛选和模型蒸馏,把漏检率从8%降至1.2%,边缘侧推理延迟压到42ms。
阅读全文关键词:推理延迟
技术应用
一家汽车供应链企业三个月只积累到100张微裂纹图。团队用CLIP变体、潜扩散模型和ControlNet补充样本,再经视觉大模型筛选和模型蒸馏,把漏检率从8%降至1.2%,边缘侧推理延迟压到42ms。
阅读全文 AI 实操指南
针对 10B 参数量级模型,在 RTX 6000 48GB 显存环境下,对比 FP8、INT4 及混合精度量化的显存占用与推理延迟,提供一套基于 TensorRT-LLM 的具体部署方案与性能实测数据。
阅读全文拍照提问时,2秒等待足以打断操作,200毫秒才接近即时反馈。3B级模型要缩短首字延迟,得同时减少权重、视觉Token与KV Cache搬运,并让量化方案真正匹配Arm指令和手机NPU。
阅读全文华南某电子元器件厂在5条SMT产线上连续测试72小时:昇腾910D平均推理延迟11.2毫秒,缺陷检出率99.4%。真正影响落地预算的,还有365W峰值功耗、整机配套和CANN算子迁移。
阅读全文 前沿研究
MoE 模型的万亿参数竞赛并未带来推理端的红利,反而因专家权重全量驻留引发的显存碎片化和访存瓶颈,让推理延迟居高不下。本文拆解 Llama-4 类架构下的调度难题,并结合昇腾等厂商的最新无损优化方案,探讨从算子调度到底层
阅读全文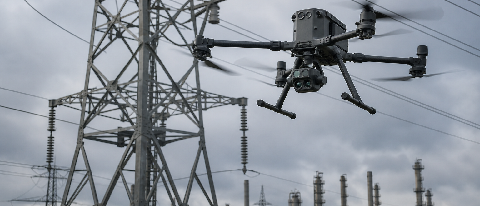 前沿研究
结合2024年HDC发布的盘古5.0,记录一次面向电力巡检场景的真实微调案例:覆盖数据清洗、LoRA调参过程中遭遇的过拟合与灾难性遗忘,以及在边缘端设备上的推理延迟测试数据与可复用经验。
阅读全文 技术应用
蚂蚁集团将风控模型部署至手机端,单笔推理延迟压至8毫秒,但高频支付场景下误拒率爬坡、隐私预算耗尽与设备覆盖率不足仍是硬约束。本文拆解端侧AI风控在支付与信贷场景下的真实工程账。
阅读全文 前沿研究
Arm正把SME2扩展到更多CPU平台,并强调内存、功耗和持续运行能力。但现有公开素材没有给出7B模型首Token延迟,也不足以证明手机端已达到150—300毫秒。
阅读全文 前沿研究
2026年7月苹果推送Vision Pro 3的AI眼动固件后,开发者实测端到端延迟仍在65-90ms区间,比前代仅改善约12%。本文从端侧NPU调度冲突、注视点渲染管线瓶颈与模型量化精度损失三个工程维度,拆解当前空间计
阅读全文 前沿研究
2026年6月底,DeepSeek开源DSpark框架,NVIDIA披露EAGLE-3方案,投机解码正式从学术概念跨入生产深水区。本文拆解vLLM与TensorRT-LLM的工程实现细节,对比显存优化、国产算力适配与硬件
阅读全文 前沿研究
2026年MoE模型竞争转向Gate网络设计。本文对比DeepSeek V4、Qwen 3、Mixtral 9x22B三种路由策略,通过消融实验量化动态负载均衡对训练收敛和推理延迟的影响,并给出可复现的PyTorch代码
阅读全文 开发者生态