7B到14B模型上手机,先过内存和功耗两道关
7B模型做INT4量化后,权重理论下限约3.5GB;14B约7GB,运行时还要给KV Cache、系统和后台应用留空间。手机NPU调度的重点,是控制上下文、算子回退和持续发热。
阅读全文关键词:NPU调度
7B模型做INT4量化后,权重理论下限约3.5GB;14B约7GB,运行时还要给KV Cache、系统和后台应用留空间。手机NPU调度的重点,是控制上下文、算子回退和持续发热。
阅读全文 前沿研究
2026年7月实测显示,端侧3B模型日均待机耗电约1.5%-2%,重度Agent调用下续航减半。量化、剪枝等轻量化方案虽降低峰值功耗,但需配合NPU调度优化才能解决发热焦虑。本文拆解vivo蓝心、小米澎湃等主流模型的功耗
阅读全文 前沿研究
2026年7月实测表明,手机运行10B参数模型已从「不能跑」跨到「可以跑」,但发烫问题并未消失。得益于NPU调度、稀疏激活与指令集优化,持续推理功耗降至4.8W,温度约45℃;但Agent场景连续调用仍会堆积热量。文章引
阅读全文 前沿研究
Fortune Business Insights预计,2026年全球边缘AI市场规模为475.9亿美元,但这一口径并非芯片销售额。端侧选型也不能只看TOPS:内存、算子回退、CPU与NPU调度以及软件适配,都会改变实际
阅读全文 AI 实操指南
把 Qwen2.5-3B-Instruct 或 Llama-3.1-8B 放进 iPhone 13、Redmi Note 12 Pro+,卡点通常落在内存、算子支持和持续发热。旧设备可先用 INT8 建立基线,再按内存压
阅读全文 前沿研究
2026年夏天,7B大模型在旗舰机上跑通已成常态,但内存占用和发热问题远比宣传复杂。实测三款旗舰机在连续对话下的内存与掉电数据,拆解手机厂商为了保住轻薄设计,在NPU调度策略上做的妥协。端侧AI的真实代价,才刚刚浮出水面
阅读全文 前沿研究
2026年7月苹果推送Vision Pro 3的AI眼动固件后,开发者实测端到端延迟仍在65-90ms区间,比前代仅改善约12%。本文从端侧NPU调度冲突、注视点渲染管线瓶颈与模型量化精度损失三个工程维度,拆解当前空间计
阅读全文 AI 工具箱
OPPO在2025年世界人工智能大会展示了200 token/s端侧模型能力,也把AI手机的真实考题暴露出来:峰值速度之外,NPU调度、量化部署、发热控制和端云协同,才决定它能不能长期好用。
阅读全文三款骁龙8 Gen5量产旗舰机实测数据出炉:NPU调度优化成功将14B模型整机功耗压至5.8W,但热成像显示SoC热点从传统中框位置横向串扰至摄像头模组,最高温度飙至47.2℃,影响握持体验并威胁CMOS成像质量。端侧大
阅读全文骁龙8 Gen5让14B模型端侧运行成为现实,但内存溢出与持续降频仍是痛点。本文结合2026年6月落地的混合精度量化与稀疏激活技术,深入解析编译器指令集优化、动态批处理及内存池化策略,提供从算子级加载到功耗控制的代码级优
阅读全文 前沿研究
基于Arm China“周易”X3的NPU动态调度思路,解决骁龙8 Gen5跑14B模型的内存溢出与前台卡顿痛点,提供算子级动态加载、内存压力感知与资源借用方案,帮助端侧开发者压榨有限算力。
阅读全文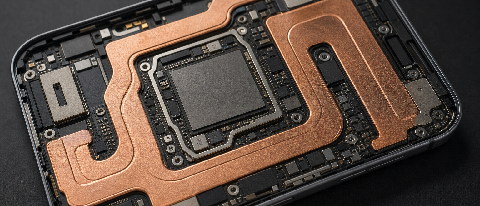 前沿研究
骁龙8 Gen5发布半年后,14B模型手机端落地遭遇散热与调度双重拷问。实测显示,INT4量化+NPU-CPU混合调度是稳态运行的关键,单纯堆砌算力无法解决热节流导致的掉帧。
阅读全文