骁龙8 Gen5实测翻车:14B模型跑顺了,但摄像头被烤到47℃
三款骁龙8 Gen5量产旗舰机实测数据出炉:NPU调度优化成功将14B模型整机功耗压至5.8W,但热成像显示SoC热点从传统中框位置横向串扰至摄像头模组,最高温度飙至47.2℃,影响握持体验并威胁CMOS成像质量。端侧大
阅读全文关键词:推理
三款骁龙8 Gen5量产旗舰机实测数据出炉:NPU调度优化成功将14B模型整机功耗压至5.8W,但热成像显示SoC热点从传统中框位置横向串扰至摄像头模组,最高温度飙至47.2℃,影响握持体验并威胁CMOS成像质量。端侧大
阅读全文骁龙8 Gen5让14B模型端侧运行成为现实,但内存溢出与持续降频仍是痛点。本文结合2026年6月落地的混合精度量化与稀疏激活技术,深入解析编译器指令集优化、动态批处理及内存池化策略,提供从算子级加载到功耗控制的代码级优
阅读全文 前沿研究
骁龙8 Gen5实测跑14B模型发热严重,但6月落地的混合精度量化与稀疏激活技术,已把内存压到5.8GB、推理功耗控在3.2W。两条算法路径叠加后,中端机本地跑大模型不再是噱头,只是加载那5秒的等待仍是工程上的最后一公里
阅读全文搭载骁龙8 Gen5的旗舰机已上市,我们断网实测了一周14B参数模型的本地推理。响应7.8秒、续航缩水三成、发热可控但持久战会降频。本文给出速度、功耗和隐私的真实数字,并对比云端API,明确判断普通用户当前是否值得为端侧
阅读全文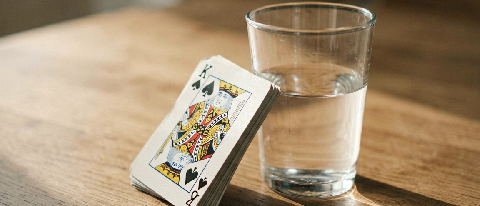 前沿研究
北京通用人工智能研究院(BIGAI)最新测试中,智能体在遮挡推断、工具替代等物理常识任务上正确率突破68%,不再依赖文本匹配,而是靠世界模型在行动前“脑补”后果。本文从一叠扑克牌和半杯水的实验切入,拆解世界模型与大模型路
阅读全文Apple M5 把 Neural Accelerator 放进 10 核 GPU 的每颗核心里,让端侧 AI 多了一条计算路径。峰值性能提升很醒目,但真正影响体验的,仍是推理、渲染、内存和功耗如何分配。
阅读全文 AI 工具箱
同跑 Qwen2.5-7B-Instruct INT4,骁龙 X Elite 上 ExecuTorch 首 token 更快,天玑 9400 上 MNN 吞吐反超,llama.cpp 胜在内存稳定。框架选择要跟芯片、任务
阅读全文 前沿研究
向量检索擅长找相似,但在跨文档、多实体关系链的查询上容易断裂。2026年,Graph RAG 通过显式构建知识图谱来支撑多跳推理与全局分析。本文拆解供应链风控、合规审计、药物研发和工业设备运维四类场景,给出可落地的选型判
阅读全文 前沿研究
骁龙8 Gen 5让14B端侧AI推理成为可能,但热节流让算力大打折扣。实测数据显示,INT4量化、NPU-CPU混合调度与内存预分配,比单纯堆砌NPU算力更能实现可持续运行,这才是2026年端侧AI落地的关键。
阅读全文 前沿研究
 前沿研究
骁龙8 Gen 5让14B端侧大模型成为现实,但高负载引发的热节流是最大拦路虎。实测数据显示,INT4量化在维持稳定性上优于INT8。本文结合高通白皮书与最新工程实践,提供从量化选择、内存调度到动态降频的代码级优化方案,
阅读全文 前沿研究
向量RAG适合找相似片段,但遇到跨文档、跨实体的问题容易断线。Graph RAG把实体、属性和关系组织成知识图谱,再结合语义检索,适合供应链、合规、法律等需要多跳推理和溯源的企业知识库。
阅读全文