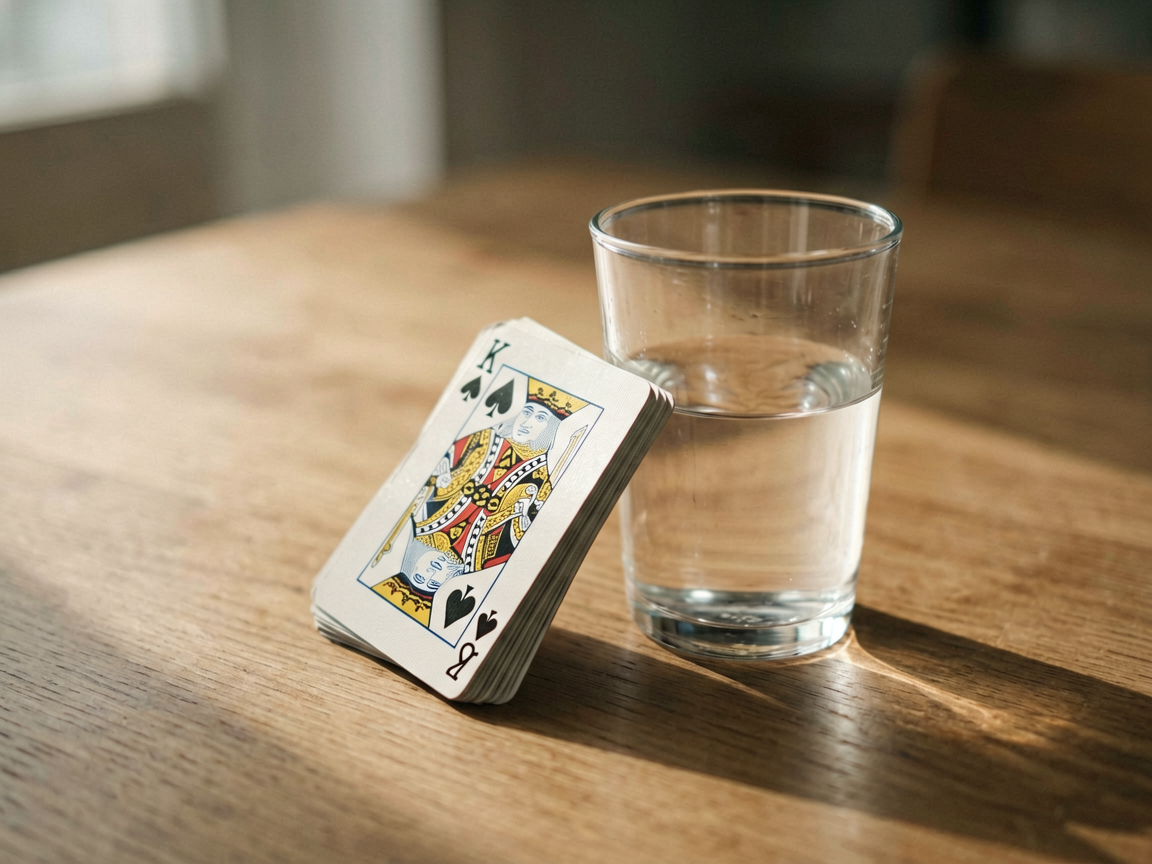
一叠扑克牌斜靠在杯子上,抽出最底下那张,整叠会不会倒?如果倒了,应该先扶哪一张?
2026年6月,北京通用人工智能研究院(BIGAI)公布的一组测试里,他们的智能体没有去翻任何物理教材,也没调用外部搜索引擎,而是在一个内部模拟的“心理空间”里推演了一遍牌的重心转移,然后给出了正确动作。这在过去五年的大模型智能体身上几乎从未稳定出现过。
测试场景被刻意设计得很“日常”:桌上有半杯水、一把剪刀、一张揉皱的纸,任务是把纸摊平。基于GPT-5或Claude 4的智能体通常会直接拿起剪刀去剪纸——它从语料里学会了“剪刀可以处理纸”,但没理解“摊平”不需要破坏物体。BIGAI的智能体则先用手按了按纸,发现按不平,才拿起剪刀,用刀背去压平纸边。整个过程没有预设脚本,完全靠实时物理推理驱动。
这个细节让很多研究者意识到,通用智能体可能正在跨过一道门槛:从“记住语言模式”转向“理解物理因果”。
两条路线的根本分歧不在参数,在于“预演”
当前主流的AI Agent,无论是基于GPT-5、Claude 4还是Gemini 2.5,核心工作流是感知-语言推理-动作指令。它们本质是在做文本模式匹配:读过无数事故报告和生活描述,但从未真正理解“倾斜”和“洒出”之间的因果关系。当问题稍微偏离常见表述——比如把“水杯”换成“锥形瓶”——匹配就开始出错。
BIGAI走的是世界模型路线。这条路的起点完全不同:它要求智能体从一开始就学习一个可运行的心理世界模型,能模拟物体运动、预测动作后果、理解因果链条。在感知和推理之间,它插入了一层“内部模拟”——先在心里推演一遍“如果我这么做,会发生什么”,然后才输出动作。
据BIGAI公布的实验数据,在包含物理常识推理的TACO(Temporal and Causal)基准上,他们的智能体在“物体稳定性判断”“工具替代使用”等子任务上,比GPT-4o的直接推理高出约34个百分点。在50个日常物理场景中,整体正确率首次突破85%,而对比测试里大模型的正确率徘徊在40%到55%之间。
BIGAI院长朱松纯在2024年8月的公开演讲中明确表达了这一分歧:“语言智能不等于通用智能,通用智能体的核心是一个能预判、能解释、能干预的世界模型。”这一理论脉络可以追溯到更早——2022年ICLR的一篇Oral论文(鲁汶大学万博为第一作者,BIGAI为通讯单位)就已提出相关基础框架。
这不仅仅是学术分歧。据《中国具身智能产业发展白皮书》(2026年5月发布)统计,2025年Q4到2026年Q1,国内具身智能创业公司中采用“端到端大模型”路线的占比从67%降到了51%,而引入世界模型或混合架构的比例从12%升至29%。宇树科技在2026年3月发布的H1-2人形机器人,其抓取策略就从纯视觉-语言映射切换到了“先模拟抓取后果再执行”的架构,在透明物体抓取成功率上提升了22个百分点。
那些“人类觉得简单”的场景,才是真正的试金石
BIGAI这次测试选了三个典型场景,每一个都精准打击了大模型的盲区。
遮挡物体推断。 桌上有三个方块,其中一个被杯子挡住一半。人类看一眼就知道那里有个方块,只是部分被遮。传统视觉模型可能直接输出“杯子”,而BIGAI的智能体能正确推断出“方块被杯子遮挡”,并规划绕到侧面去拿。这需要智能体在心理空间里“补全”被遮挡的几何结构,而不是仅仅识别可见像素。
工具的非标准使用。 需要把一颗钉子敲进木板,手边只有一把扳手。智能体没有在训练数据中见过“用扳手敲钉子”,但它通过观察扳手的重量和硬度,在内部模拟中判断出可以替代锤子。这背后是对“任何足够重且硬的物体都可以当锤子”这一抽象物理常识的掌握。
多步因果链。 一个遥控器放在沙发上,沙发靠垫立着。任务是把电视打开。智能体需要先推倒靠垫(因为遥控器藏在靠垫后面),再拿起遥控器,再对准电视按按钮。任何一步出错都会导致任务失败。BIGAI的智能体在内部模拟中推演了完整的因果链条,而非逐步试错。
这三类场景的成功率从一年前的不足30%提升到了68%左右,距离人类95%以上的水平还有差距,但进步曲线陡峭。
落地面前横着三道硬坎
跑分漂亮,但把这类智能体推到真实场景里,至少还有三道坎。
第一道坎:世界模型的训练数据从哪来。 语言模型可以吃掉整个互联网的文本,但世界模型需要的是物理交互数据——物体掉落、液体晃动、碰撞形变。这类数据没法从网页上爬取,只能从仿真环境或真实机器人采集。BIGAI团队在2025年发表的一篇论文中提到,训练一个能处理50种日常物理场景的世界模型,需要约200万条交互序列,每条包含RGB-D视频和力反馈数据。采集成本比语言数据高出一个数量级。目前这条路主要依赖合成数据,BIGAI自己开发了名为“通境”的仿真平台自动生成交互场景。但仿真到真实的迁移gap依然存在——在仿真里学会的倒水判断,遇到真实世界里杯壁有水珠、桌面微倾斜的情况,还是会出错。
第二道坎:推理成本比说话贵得多。 大模型推理是一遍过——输入文本,输出文本。世界模型推理是循环的:先模拟,观察结果,如果不确定就调整参数再模拟,直到置信度够高才输出判断。BIGAI这次测试中,单个常识推理任务的平均模拟次数是3.7次。这意味着每做一次判断,计算量是大模型直接推理的3到4倍。如果把这种架构塞进需要实时响应的机器人系统,延迟会立刻成为瓶颈。目前的做法是在云端跑世界模型,端侧只执行结果,但这又把智能体绑在了网络延迟上。
第三道坎:怎么评估“常识”本身就没有共识。 大模型有MMLU、HumanEval这类标准化基准,但常识推理至今没有一个公认的评测体系。BIGAI这次的50个场景是自己设计的,别人可以质疑场景选择是否公正、难度是否合理。更麻烦的是,常识本身有文化差异——在中国语境下“杯子会不会裂”的答案,跟北欧用户冬天从室外拿杯子进室内的经验可能完全不同。2026年5月,Anthropic发布的一份Agent评估研究报告明确指出:“当前Agent评测的最大空白不是能力维度缺失,而是缺乏跨文化、跨物理环境的常识一致性测试。”这个空白,恰恰是世界模型路线最需要证明自己的地方。
两条路线短期内会共存,但融合方向已现
就在BIGAI发布测试结果的同一周,AI Agent生态发生了两件事:Anthropic的MCP协议被更多工具厂商接入,谷歌发布了A2A协议允许不同厂商的Agent直接通信协作。这两件事的本质,都是用工程手段弥补大模型在物理常识上的不足——既然模型自己不懂“怎么用扳手敲钉子”,那就让它调用一个已经写好的工具函数。
BIGAI的路线则试图从更底层解决问题:让模型自己学会“锤子”的概念,而不是靠外部工具库。这两种思路短期内会共存:大模型加工具调用适合数字化场景(客服、编程、数据分析),世界模型适合物理场景(机器人、自动驾驶、智能制造)。我们在之前的文章《BIGAI押注世界模型,机器人要先学会预判》中讨论过,具身智能的重点正在从“把动作做出来”推向“先判断动作后果”。长期来看,如果世界模型能持续降低训练成本,两者可能会融合——就像人类既靠语言常识又靠物理直觉来处理问题。
BIGAI这次的跑分,最值得关注的不是那个68%或85%的数字,而是它证明了“让机器学会物理常识”这条路走得通。过去几年,AI行业习惯了堆参数、堆数据、堆算力,但常识推理偏偏不吃这一套——你给模型1000万条“玻璃杯掉到地上会碎”的文本,它依然不知道玻璃杯掉到地上意味着什么。你需要让它真的在心理空间里“摔”一次。
这种路线分歧,最终会决定通用智能体到底能走多远。