 AI 工具箱
昇腾910D算子别急着手调,先让编译器跑一轮
在昇腾910D部署中,自定义算子变慢时,先用CANN 8 profiling查清耗时、通信、内存和下发问题,再判断是否融合与自动搜索。以RMSNorm和Gated-SiLU为例,说明Auto-Kernel与手写Trito
阅读全文关键词:优化
AI 工具箱
在昇腾910D部署中,自定义算子变慢时,先用CANN 8 profiling查清耗时、通信、内存和下发问题,再判断是否融合与自动搜索。以RMSNorm和Gated-SiLU为例,说明Auto-Kernel与手写Trito
阅读全文针对国产算力集群在多机多卡通信中的“延迟墙”问题,北京通用人工智能研究院(BIGAI)通过一套新的通信拓扑调度架构,将集群同步延迟降低了40%。本文拆解其从算子级优化到拓扑感知的技术路径,分析该突破如何降低中小开发者的训
阅读全文通过对比传统 PID 控制与 AI 强化学习调度在某头部电池电芯工厂的实测表现,揭示工业 AI 如何在峰谷电价切换的毫秒级响应中,将整体能耗降低 12%,实现从“对话框”到“生产线”的价值闭环。
阅读全文 AI 实操指南
长链路 Agent 容易在工具调用之间反复打转。把重试次数、错误信息和人工审批写进状态,再用 LangGraph 的条件边控制去向,可以让修复循环在达到上限后退出,转入人工处理或降级流程。
阅读全文Agent 在长任务里跑偏,继续往 Prompt 里加规则,常常只会让首轮输入更臃肿。更稳妥的做法,是把生成、评估、修正拆开,再用 PASS、最大轮次、状态机和人工审核管住循环。
阅读全文 AI 工具箱
国产芯片适配真正耗时的往往不是模型迁移,而是算子融合、分块和访存。文章以 RMSNorm + Gated-SiLU 为例,说明 2026 版 Auto-Kernel 如何为昇腾 910D 生成并调优算子,也交代 240
阅读全文针对昇腾910D大规模集群训练中常见的通信瓶颈问题,本文通过实测数据分析多机AllReduce延迟原因,提供一套从拓扑感知到HCCL参数调优的实操方案,旨在将千卡集群的MFU(模型算力利用率)从30%量级提升至50%以上
阅读全文 前沿研究
IQM借SPAC上市、三星研究量子计算与AI光刻仿真、45纳米电子—光子—量子芯片接连出现。但资本动作、研发计划和硬件原型不是同一类证据。NISQ设备更适合处理量子化学、组合优化等窄任务,主流AI尚无可靠的端到端提速结果
阅读全文 开发者生态
团队把基座模型微调从英伟达A100迁到8卡昇腾910C的Atlas 800。三个月后,最耗时的不是改接口,而是复合算子、显存碎片和跨机AllReduce。附内部实测与九项检查清单。
阅读全文 AI 实操指南
当 Agent 在多步任务里反复跑偏,继续加“请一步步思考”往往只能改变当次输出。GRPO 去掉 Critic,用同题多回答的相对得分更新模型,把优化重点移到可验证的奖励规则。
阅读全文 技术应用
2026年上半年金融、电商、出行三大行业的日志显示,客服Agent情绪识别准确率远低于宣传的95%。本文拆解幻觉、违规与误判背后的三大根源:训练语料的静态偏差、多模态模型的实时延迟、以及决策流程中权限与情绪的冲突。
阅读全文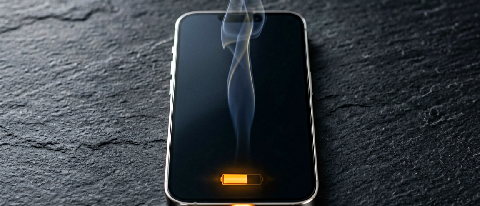 前沿研究
2026年7月实测显示,端侧3B模型日均待机耗电约1.5%-2%,重度Agent调用下续航减半。量化、剪枝等轻量化方案虽降低峰值功耗,但需配合NPU调度优化才能解决发热焦虑。本文拆解vivo蓝心、小米澎湃等主流模型的功耗
阅读全文