 前沿研究
万亿模型继续变大,企业却在重算3B的账
Kimi K3把开源模型推到2.8万亿参数,企业部署端却在问:哪些请求真的需要旗舰模型?3B小模型的价值不在全面平替,而在任务清楚、调用频繁且有兜底的场景里,控制时延和持续成本。
阅读全文关键词:推理
前沿研究
Kimi K3把开源模型推到2.8万亿参数,企业部署端却在问:哪些请求真的需要旗舰模型?3B小模型的价值不在全面平替,而在任务清楚、调用频繁且有兜底的场景里,控制时延和持续成本。
阅读全文 前沿研究
vLLM更适合请求波动大、模型切换频繁的服务;TensorRT-LLM更适合NVIDIA硬件上模型稳定、愿意承担编译维护成本的场景。压测必须固定模型、精度、上下文、并发和硬件,单独的吞吐数字无法直接换算成成本。
阅读全文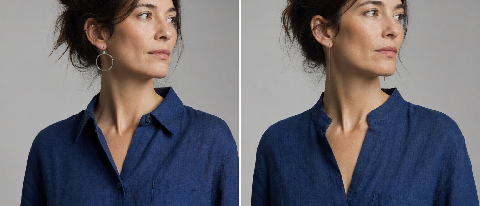 前沿研究
第1分钟还是深蓝色亚麻衬衫,第5分钟耳钉和领口已经变样。Sora 3、Runway Gen-4把单镜头做得更精细后,长视频的时间一致性问题更加显眼。3D先验可锁住场景,角色LoRA可约束身份,但会换来更高显存占用和更慢推
阅读全文 技术应用
在 35℃ 恒温箱环境下,iPhone 16 Pro Max、Galaxy S25 Ultra 和小米 15 Pro 持续推理 20 分钟后,Token 生成速度分别跌至初始值的 58%、50% 和 72%。本文量化分析
阅读全文 前沿研究
同一张 RTX 4090 上,128 份中文合同、最长 131K token。RWKV-6 显存最低、出首 token 最快,Qwen2.5 平均漏检最低,Mamba-3 居中。三种架构的取舍,最终落在推理成本与人工复核
阅读全文在35℃恒温模拟舱内,2026款理想L9、小鹏G9和问界M9连续运行36小时,循环执行多轮语音与导航规划。三款车都完成了测试,但热管理路径不同:M9波动较小,L9中后段降频明显,G9优先保住语音响应。
阅读全文Nanbeige4-3B让3B级SLM进入企业候选清单,但现有材料还不足以证明它们普遍追平千亿、万亿参数模型。合同审查和医疗分诊能否上线,得看严重漏检、知识更新、真实硬件表现与人工兜底,而不是只看榜单。
阅读全文 技术应用
《工业与AI融合应用指南》落地后,长三角一家零部件厂把质检模型从 ResNet 换到 ViT-Lite。两周内,他们重新标注了 3.6 万张图、换了两张推理卡,并把误检率从 1.4% 压到 0.6%。本文逐项摊开这台账。
阅读全文针对2026年6月金融监管总局最新的AI安全应用指导意见,本文详解如何构建一个多Agent协作系统,实现从发票识别到凭证生成的全链路自动化,并重点探讨如何通过构建不可篡改的推理链路,满足审计追踪的合规要求。
阅读全文按席位和年费卖 Agent,客户很难判断钱花得值不值。2026 年,设备预测性检修等可核验场景开始尝试按效果收费,但结果如何定义、收益归谁、推理成本能否覆盖,决定了这套模式能走多远。
阅读全文基础模型竞争正向头部集中,推理需求则把成本拉到每一次调用上。2026年四家科技巨头资本支出预计达6600亿美元,推理芯片占AI芯片市场的52%。创业公司需要重算模型路由、交付成本和续费,把参数能力变成可持续收入。
阅读全文分析 VibeThinker 等 3B 规模端侧模型如何通过 GRPO 强化学习实现类似 o1 的慢思考(CoT)能力,探讨在内存与功耗约束下,端侧模型如何通过牺牲推理时间换取逻辑能力的跃迁,并为开发者提供端侧推理优化的
阅读全文