 前沿研究
7B模型进手机,联发科和高通还差哪一步
Arm正推动移动AI从单点算力竞争转向整套计算栈协同。对联发科和高通来说,7B模型能否进入手机,关键还要看内存占用、软硬件适配和系统调度,现有公开材料尚不足以判断谁会率先落地。
阅读全文关键词:手机
前沿研究
Arm正推动移动AI从单点算力竞争转向整套计算栈协同。对联发科和高通来说,7B模型能否进入手机,关键还要看内存占用、软硬件适配和系统调度,现有公开材料尚不足以判断谁会率先落地。
阅读全文 前沿研究
Arm 在 2026 年 6 月更新移动 AI 架构路线图后,旗舰手机端侧大模型的参数竞赛被按下暂停键。厂商宣传的“百亿参数端侧运行”在功耗墙、内存带宽和实际可用容量面前,需要重新算账。本文拆解 2026 年下半年旗舰
阅读全文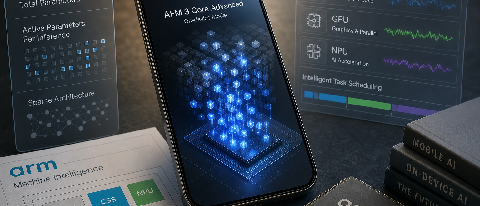 产业动态
苹果把AFM 3 Core Advanced做到约200亿参数,却通过稀疏架构控制单次推理的激活规模。结合Arm对CPU、GPU、NPU协同的强调,手机端侧选型需要重新评估实际计算量、部署适配和任务调度。
阅读全文 前沿研究
荣耀用低bit量化缩小模型、提高推理速度,Nexa AI则试图降低跨芯片部署成本。端侧AI能否真正进入手机日常,还要看相册搜索、输入法和离线翻译是否够快、够稳,也不能太耗电。
阅读全文 技术应用
蚂蚁集团将风控模型部署至手机端,单笔推理延迟压至8毫秒,但高频支付场景下误拒率爬坡、隐私预算耗尽与设备覆盖率不足仍是硬约束。本文拆解端侧AI风控在支付与信贷场景下的真实工程账。
阅读全文 前沿研究
Arm正把SME2扩展到更多CPU平台,并强调内存、功耗和持续运行能力。但现有公开素材没有给出7B模型首Token延迟,也不足以证明手机端已达到150—300毫秒。
阅读全文 产业动态
端侧大模型进入手机和PC后,芯片性能已不能只看TOPS。Arm推出Lumex CSS并引入SME2,试图从CPU、GPU、系统IP和数据搬运入手,缓解算力、内存与功耗之间的牵制。
阅读全文 前沿研究
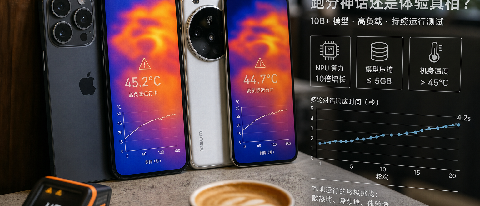 前沿研究
2026年旗舰机宣称的“本地运行”面临严峻考验。实测发现,即便搭载最强NPU,10B+模型在高负载下依然触发降频,发热导致体验断崖式下跌。真正的差距不在参数大小,而在软硬件协同与稀疏架构。
阅读全文 技术应用
公开素材还不足以支撑“2026下半年真实功耗实测”的说法。更可靠的看点是,Arm、苹果等厂商正在把端侧AI竞争从模型压缩,推向芯片、运行时、工具链和设备场景的协同。
阅读全文 AI 工具箱
用一台骁龙8 Gen3、12GB内存的小米14 Pro实测Wan2.1 1.3B量化版:生成15秒720p短片耗时38分12秒,峰值内存8.7GB,温度接近70℃。它还谈不上好用,但本地跑通已经不是空想。
阅读全文