端侧NPU调度优化:让14B模型在骁龙8 Gen5上流畅运行的秘诀
骁龙8 Gen5让14B模型端侧运行成为现实,但内存溢出与持续降频仍是痛点。本文结合2026年6月落地的混合精度量化与稀疏激活技术,深入解析编译器指令集优化、动态批处理及内存池化策略,提供从算子级加载到功耗控制的代码级优
阅读全文关键词:NPU
骁龙8 Gen5让14B模型端侧运行成为现实,但内存溢出与持续降频仍是痛点。本文结合2026年6月落地的混合精度量化与稀疏激活技术,深入解析编译器指令集优化、动态批处理及内存池化策略,提供从算子级加载到功耗控制的代码级优
阅读全文 前沿研究
基于Arm China“周易”X3的NPU动态调度思路,解决骁龙8 Gen5跑14B模型的内存溢出与前台卡顿痛点,提供算子级动态加载、内存压力感知与资源借用方案,帮助端侧开发者压榨有限算力。
阅读全文搭载骁龙8 Gen5的旗舰机已上市,我们断网实测了一周14B参数模型的本地推理。响应7.8秒、续航缩水三成、发热可控但持久战会降频。本文给出速度、功耗和隐私的真实数字,并对比云端API,明确判断普通用户当前是否值得为端侧
阅读全文Apple M5 把 Neural Accelerator 放进 10 核 GPU 的每颗核心里,让端侧 AI 多了一条计算路径。峰值性能提升很醒目,但真正影响体验的,仍是推理、渲染、内存和功耗如何分配。
阅读全文 前沿研究
骁龙8 Gen5发布半年后,14B模型手机端落地遭遇散热与调度双重拷问。实测显示,INT4量化+NPU-CPU混合调度是稳态运行的关键,单纯堆砌算力无法解决热节流导致的掉帧。
阅读全文 前沿研究
骁龙8 Gen 5让14B端侧AI推理成为可能,但热节流让算力大打折扣。实测数据显示,INT4量化、NPU-CPU混合调度与内存预分配,比单纯堆砌NPU算力更能实现可持续运行,这才是2026年端侧AI落地的关键。
阅读全文 技术应用
2026年旗舰机NPU算力破百,但本地跑通7B-14B模型仍遇功耗与适配瓶颈。实测骁龙8 Gen 5与鸿蒙NEXT,对比云端API,拆解离线场景下的隐私与体验差异,给出购机与开发建议。
阅读全文 前沿研究
2026年旗舰机NPU算力突破100TOPS,但本地运行7B-14B模型仍卡顿、耗电。实测荣耀、小米、OPPO三款新机,解析芯片厂、手机厂商与APP开发者的三方博弈,并给出选购建议。端侧AI的爆发,最终不是算力军备竞赛能
阅读全文 前沿研究
2026年旗舰机运行大模型频繁过热降频,用户感觉“烫手”而非“智能”。本文对比高通、联发科及自研芯片的功耗策略差异,分析石墨烯散热、均热板等散热材料进展,探讨能效比如何在算力竞争中成为新焦点。
阅读全文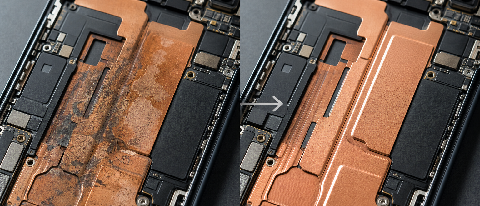 技术应用
端侧AI开始从发布会走向手机和PC。苹果上VC均热板,谷歌把Gemini Nano放到端侧,小米推出MiMo-V2 Pro。参数和响应速度之外,发热、续航和降频正在变成用户最先感知的问题。
阅读全文 前沿研究
Apple Intelligence 2.0把Siri推向更复杂的AI能力,也把端侧NPU的上限摆到台前。苹果选择本地小模型、私有云和Gemini协作,但硬件门槛、云端依赖和隐私边界都会影响用户体验。
阅读全文 前沿研究