 开发者生态
华为昇腾910D量产实测:CANN迁移痛点与CUDA对比
华为昇腾910D集群实测:算子覆盖率75%、训练稳定性256卡通信瓶颈、调试工具链差距。从PyTorch到CANN的迁移成本与国产算力生态进展,基于真实项目数据深度拆解。
阅读全文关键词:实测
开发者生态
华为昇腾910D集群实测:算子覆盖率75%、训练稳定性256卡通信瓶颈、调试工具链差距。从PyTorch到CANN的迁移成本与国产算力生态进展,基于真实项目数据深度拆解。
阅读全文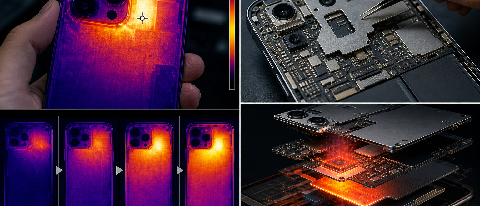 前沿研究
骁龙8 Gen5在跑14B端侧模型时,摄像头区域温度飙至52°C以上。硬件工程师实测四款旗舰,发现问题不在散热面积,而在NPU热密度失控和摄像头支架造成的热传导死胡同。不同厂商的温控策略从激进降频到偷偷降精度,都在掩盖一
阅读全文Qwen3发布两个月后,我们拿法律合同、券商研报和招股书做了一轮中文长文档实测。在100K上下文场景下,Qwen3-235B的召回率逼近Claude 3.5 Sonnet,但幻觉率和长文本中间丢失问题仍是硬伤。Qwen3
阅读全文三款骁龙8 Gen5量产旗舰机实测数据出炉:NPU调度优化成功将14B模型整机功耗压至5.8W,但热成像显示SoC热点从传统中框位置横向串扰至摄像头模组,最高温度飙至47.2℃,影响握持体验并威胁CMOS成像质量。端侧大
阅读全文2026年上半年,多地8000P智算中心空置率超40%,传统K8s调度导致MFU仅45%。实测显示,引入显存池化与拓扑感知算法后,异构集群MFU可从45%跃升至58%。算力运营正从拼硬件转向拼算法,解决显存碎片与跨架构通
阅读全文 前沿研究
骁龙8 Gen5实测跑14B模型发热严重,但6月落地的混合精度量化与稀疏激活技术,已把内存压到5.8GB、推理功耗控在3.2W。两条算法路径叠加后,中端机本地跑大模型不再是噱头,只是加载那5秒的等待仍是工程上的最后一公里
阅读全文搭载骁龙8 Gen5的旗舰机已上市,我们断网实测了一周14B参数模型的本地推理。响应7.8秒、续航缩水三成、发热可控但持久战会降频。本文给出速度、功耗和隐私的真实数字,并对比云端API,明确判断普通用户当前是否值得为端侧
阅读全文 前沿研究
2026年夏季高温来袭,传统风冷数据中心 PUE 飙升至 1.5 以上。本文实地探访河北某浸没式液冷智算园区,对比极端温度下液冷与风冷的真实 PUE 差距(1.09 vs 1.52),通过电费账单、建设成本与运维细节,揭
阅读全文 AI 工具箱
同跑 Qwen2.5-7B-Instruct INT4,骁龙 X Elite 上 ExecuTorch 首 token 更快,天玑 9400 上 MNN 吞吐反超,llama.cpp 胜在内存稳定。框架选择要跟芯片、任务
阅读全文 前沿研究
骁龙8 Gen5发布半年后,14B模型手机端落地遭遇散热与调度双重拷问。实测显示,INT4量化+NPU-CPU混合调度是稳态运行的关键,单纯堆砌算力无法解决热节流导致的掉帧。
阅读全文 前沿研究
骁龙8 Gen 5让14B端侧AI推理成为可能,但热节流让算力大打折扣。实测数据显示,INT4量化、NPU-CPU混合调度与内存预分配,比单纯堆砌NPU算力更能实现可持续运行,这才是2026年端侧AI落地的关键。
阅读全文 前沿研究
骁龙8 Gen 5让14B端侧大模型成为现实,但高负载引发的热节流是最大拦路虎。实测数据显示,INT4量化在维持稳定性上优于INT8。本文结合高通白皮书与最新工程实践,提供从量化选择、内存调度到动态降频的代码级优化方案,
阅读全文