 AI 实操指南
10B模型如何在单卡RTX 6000上实现毫秒级响应:量化实战
针对 10B 参数量级模型,在 RTX 6000 48GB 显存环境下,对比 FP8、INT4 及混合精度量化的显存占用与推理延迟,提供一套基于 TensorRT-LLM 的具体部署方案与性能实测数据。
阅读全文关键词:端侧推理
AI 实操指南
针对 10B 参数量级模型,在 RTX 6000 48GB 显存环境下,对比 FP8、INT4 及混合精度量化的显存占用与推理延迟,提供一套基于 TensorRT-LLM 的具体部署方案与性能实测数据。
阅读全文2026年端侧AI已从跑分转向体感优化。本文通过拆解3B-7B模型的首token延迟(TTFT),分析内存带宽瓶颈与KV Cache压缩技术,探讨硬件厂商如何通过架构升级解决AI手机卡顿,揭示端侧推理的真实性能分水岭。
阅读全文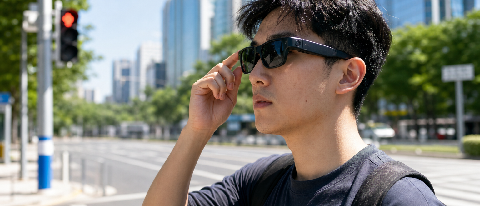 技术应用
三款AI原生眼镜在37℃户外接受2公里步行导航测试。10万勒克斯强光导致视觉过曝,高温把最慢语音响应拉到4.2秒;唯一可独立导航的产品在22分钟后镜腿达到46.2℃,电量从90%降至30%。眼镜能减少看屏,暂时还接不了手
阅读全文在35℃恒温模拟舱内,2026款理想L9、小鹏G9和问界M9连续运行36小时,循环执行多轮语音与导航规划。三款车都完成了测试,但热管理路径不同:M9波动较小,L9中后段降频明显,G9优先保住语音响应。
阅读全文分析 VibeThinker 等 3B 规模端侧模型如何通过 GRPO 强化学习实现类似 o1 的慢思考(CoT)能力,探讨在内存与功耗约束下,端侧模型如何通过牺牲推理时间换取逻辑能力的跃迁,并为开发者提供端侧推理优化的
阅读全文 产业动态
2026年Q2,AI融资逻辑发生根本逆转,资本从参数军备赛转向效率与落地。本文通过模型蒸馏、端侧部署和算子调优等轻量化技术案例,揭示算力成本高企下创业公司如何构建商业闭环,包括银行反欺诈、端侧推理、国产芯片等实战。
阅读全文 产业动态
2026年第二季度,AI融资逻辑发生根本逆转。据新华网5月报道,算力正从科学智能向工业、能源全面渗透,资本随之从“参数军备赛”转向“效率与落地”。从昇腾910D的算子调优到南方电网的毫秒级调度,再到端侧推理的内存墙突破,
阅读全文 前沿研究
一组实测里,24GB 内存的骁龙 8 Gen 5 手机运行 INT4 量化 32B 模型,十分钟后从每秒 8 token 降到 3 token。端侧部署该比的,不只是参数量,而是底座常驻、插件路由、内存搬运和芯片适配能否
阅读全文 前沿研究
2025年底深蓝获首批L3号牌,乘联数据显示新能源L2+装车率超82%。但暴雨与无保护左转等长尾场景仍是技术瓶颈,端侧推理带宽受限加剧了这一难题。系统日志成为事故定责的核心,其不可篡改性是L3时代权责界定的关键。
阅读全文 技术应用
2026年,车载AI Agent开始从语音问答走向多模态感知、工具调用和主动服务。放到停车场剐蹭场景,它可以帮车主找记录、理清时间线、生成陈述,但责任认定仍取决于证据效力和外部处理流程。
阅读全文 AI 工具箱
chacun.cpp 开源一周,Star 数突破 8500。我们把它装进 4GB 内存的 iPhone 11,复现读取 3.2MB CSV、三次工具调用和摘要生成:首次运行峰值占用 3.8GB,量化后常驻内存降到约 1.
阅读全文 技术应用
小鹏于2026年4月发布的世界模型X-World已用于第二代VLA研发,但其工程价值最先在代客泊车场景被验证。本文从端侧推理路径出发,对比BEV+Occupancy方案,写清楚3D占据网络如何在多层停车场处理临时障碍物、
阅读全文