 前沿研究
通通3.0亮相,BIGAI还缺一张成本表
2026中关村论坛上,BIGAI发布通通3.0和“通脑”。公开材料写清了空间、认知、社交能力及“AI小镇”,却没有系统规模、训练时长、算力、能耗和与2.0同口径的效率对比。能力升级可见,成本边界仍不清楚。
阅读全文关键词:能耗
前沿研究
2026中关村论坛上,BIGAI发布通通3.0和“通脑”。公开材料写清了空间、认知、社交能力及“AI小镇”,却没有系统规模、训练时长、算力、能耗和与2.0同口径的效率对比。能力升级可见,成本边界仍不清楚。
阅读全文通过对比传统 PID 控制与 AI 强化学习调度在某头部电池电芯工厂的实测表现,揭示工业 AI 如何在峰谷电价切换的毫秒级响应中,将整体能耗降低 12%,实现从“对话框”到“生产线”的价值闭环。
阅读全文 产业动态
实地探访华东某8000P算力园区,以运营工程师视角拆解一张高达860万的月度电费单。文章深度复盘高密机柜的功率约束,对比冷板式与浸没式液冷架构在不同IT负载下的真实PUE表现,并揭示算力闲置期因底座设备空转造成的结构性能
阅读全文据公开通报,昇腾910C集群已完成1.6万亿参数DeepSeek-V4-Pro全参数后训练,但通报未披露卡数、PUE、故障率和运保成本。准备扩到万卡时,能耗边界、备件粒度、版本适配与服务响应,都应写进验收和合同。
阅读全文 前沿研究
苹果把省电做进约200亿参数的稀疏模型,高通则用混合精度降低推理能耗,并称骁龙8 Gen 4端侧大模型功耗下降40%。两套方案暂时缺少统一实测,38TOPS也不能代替持续运行时的温度、降频和适配成本。
阅读全文英伟达Vera Rubin采用全液冷、零风扇设计,华为也把热管理列为AIDC关键技术。进入2026年三季度,高密度AI数据中心已开始围绕液冷重新设计机柜、管路与运维体系。
阅读全文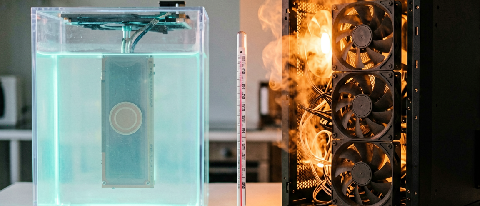 前沿研究
2026年夏季高温来袭,传统风冷数据中心 PUE 飙升至 1.5 以上。本文实地探访河北某浸没式液冷智算园区,对比极端温度下液冷与风冷的真实 PUE 差距(1.09 vs 1.52),通过电费账单、建设成本与运维细节,揭
阅读全文 深度观察
深圳河套学院8000P昇腾集群落地两个月,电费单飙到380万,PUE从1.15爬至1.22。本文从运维工程师视角拆解液冷全生命周期成本、工程隐形天花板,为中型企业算力采购提供真实决策参考。
阅读全文 AI 工具箱
算力下放不等于成本无忧。2026年下半年,面对B300的高昂能耗与采购门槛,中小企业应摒弃“全量微调”的执念,转向以RAG为核心的架构。通过FP8混合精度、INT量化与混合检索技术,在有限预算下实现高准确率的企业内部知识
阅读全文 前沿研究
2026年暑期,北京、上海、武汉等地的“AI交通大脑”正通过动态信号灯配时与公交智能调度重塑出行体验。实测数据显示部分区域高峰车速提升22%,但算力能耗与数据孤岛仍是亟待跨越的现实瓶颈。
阅读全文 前沿研究
北京AGI园区8000P集群实测数据显示,推理算力正成为智算中心的核心消耗。对比华为昇腾、寒武纪及海光在大规模并发下的延迟、吞吐量与能耗,揭示除H800外真正支撑推理成本的“隐形冠军”。
阅读全文DeepSeek蒸馏模型在香橙派和玄铁C920上的快速适配,展示了端侧算力优化的方向。LPDDR5X/6的普及让手机运行量化大模型成为可能,但42℃的温度墙和能耗比限制了其实用性。端侧AI更多是隐私保护和高频轻量任务的补
阅读全文