8000P园区很大,中型公司的算力账要另算
8000P解决的是区域算力供给,不是一家中型公司的采购答案。算力租赁、专属云和本地集群怎么选,要看负载是否稳定、数据能否出域、团队能否运维,以及每次有效调用的真实成本。
阅读全文关键词:运维
8000P解决的是区域算力供给,不是一家中型公司的采购答案。算力租赁、专属云和本地集群怎么选,要看负载是否稳定、数据能否出域、团队能否运维,以及每次有效调用的真实成本。
阅读全文 前沿研究
千卡集群利用率常低于60%,调度开销藏在NCCL通信、显存碎片和异构排队里。结合深圳14000P集群与一线运维经验,给出五项可落地的调优动作,包括网络拓扑感知、显存池预分配和芯片亲和性分组。
阅读全文AI Agent进入生产环境后,模型调用费只是账单的一角。系统集成、人工复核、运维、合规和自动续费都会影响ROI。文章依据公开资料,给出场景核算方法、成本表和上线检查清单。
阅读全文视频生成要算到成片,Agent框架要看流程能否收住,国产算力则要把迁移和运维算进去。Sora 3.5、LangGraph、AutoGen与昇腾910D的取舍,最终都落在交付成本和团队能力上。
阅读全文 前沿研究
从H100的700W到B200/B300的1000W以上,AI服务器把散热压力推到新量级。2026年,液冷从试点走向规模化,PUE口径、系统兼容、改造成本和长期运维比单次演示数据更值得看。
阅读全文 AI 实操指南
一套混合集群能否上线,关键看算子重写、数值对齐、HCCL/NCCL双栈、预热和运维。现有记录给出20天迁移、8ms延迟、45秒预热等数据,但测试配置并不完整,适合做项目预算,不宜直接外推为芯片结论。
阅读全文在2026年盛夏的电网压力下,一个8000P算力中心如何生存?本文实地拆解运维团队利用电价峰谷实施的“间歇性调度”方案,揭示在Rubin等超高功耗芯片时代,液冷虽能降PUE,但电力成本与电网负荷才是真正决定算力利用率的物
阅读全文截至2024年底,全国人工智能园区已超100个,市场却同时出现项目中标、合同终止、老旧机房闲置和智能算力短缺。症结不在总P数,而在设备代际、任务适配、交付和运维:园区卖的不是账面规模,而是能按时把任务跑完的资源。
阅读全文 产业动态
部分国产产品的FP16峰值算力已突破500 TOPS,但项目验收还要看集群扩展、软件迁移、故障恢复和长期运维。随着推理需求与国产化采购加快,参数表只能承担第一轮筛选。
阅读全文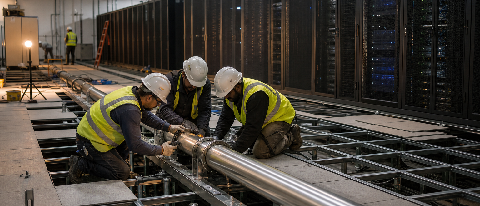 技术应用
当单芯片功耗突破2000W,风冷彻底失效。本文实地拆解一座8000P算力园区从风冷向液冷改造的真实账本:PUE从1.35降至1.08,每P算力年省14万元电费,但改造成本高达2.2亿元。冷却不再只是运维问题,它直接决定了
阅读全文 产业动态
英伟达B300放量、国产千卡集群密集交付,三家算力采购负责人在Q3预算切分上撞到同一道墙:账面报价之外,交付周期、迁移成本、隐性运维才是决定三季度账本的真正变量。
阅读全文 技术应用