 开发者生态
手机跑7B和12B模型,INT4还是FP8更合适
这组2026年7月测试把Llama 3.2 7B和Mistral Small 12B放到骁龙8 Gen5参考设计机与A19设备上,连续生成512 tokens。INT4最省内存、温度最低;FP8在A19上速度接近INT4
阅读全文关键词:骁龙8 Gen5
开发者生态
这组2026年7月测试把Llama 3.2 7B和Mistral Small 12B放到骁龙8 Gen5参考设计机与A19设备上,连续生成512 tokens。INT4最省内存、温度最低;FP8在A19上速度接近INT4
阅读全文 前沿研究
 前沿研究
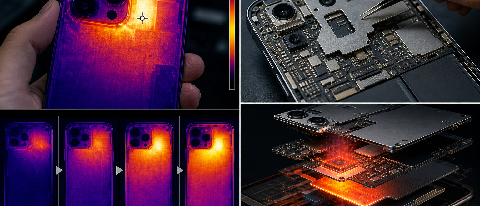
骁龙8 Gen5在跑14B端侧模型时,摄像头区域温度飙至52°C以上。硬件工程师实测四款旗舰,发现问题不在散热面积,而在NPU热密度失控和摄像头支架造成的热传导死胡同。不同厂商的温控策略从激进降频到偷偷降精度,都在掩盖一
阅读全文 前沿研究
骁龙8 Gen5把14B模型跑顺了,功耗压到5.8W,但摄像头被烤到47.2℃。苹果传用2nm,谷歌押TPU,真正卡脖子的不是跑分,是散热、内存带宽和一套至今没人能用的跨平台SDK。端侧AI从能跑到能用,中间还隔着三个没
阅读全文三款骁龙8 Gen5量产旗舰机实测数据出炉:NPU调度优化成功将14B模型整机功耗压至5.8W,但热成像显示SoC热点从传统中框位置横向串扰至摄像头模组,最高温度飙至47.2℃,影响握持体验并威胁CMOS成像质量。端侧大
阅读全文骁龙8 Gen5让14B模型端侧运行成为现实,但内存溢出与持续降频仍是痛点。本文结合2026年6月落地的混合精度量化与稀疏激活技术,深入解析编译器指令集优化、动态批处理及内存池化策略,提供从算子级加载到功耗控制的代码级优
阅读全文 前沿研究
当骁龙8 Gen5让14B模型在手机端离线运行成为现实,手机AI的竞赛从算力转向数据。通过本地RAG技术构建个人知识库,苹果、华为、安卓厂商围绕“记忆”展开新争夺。隐私计算成为关键,但权限管理和工程化仍是挑战。
阅读全文 前沿研究
基于Arm China“周易”X3的NPU动态调度思路,解决骁龙8 Gen5跑14B模型的内存溢出与前台卡顿痛点,提供算子级动态加载、内存压力感知与资源借用方案,帮助端侧开发者压榨有限算力。
阅读全文 前沿研究
骁龙8 Gen5实测跑14B模型发热严重,但6月落地的混合精度量化与稀疏激活技术,已把内存压到5.8GB、推理功耗控在3.2W。两条算法路径叠加后,中端机本地跑大模型不再是噱头,只是加载那5秒的等待仍是工程上的最后一公里
阅读全文搭载骁龙8 Gen5的旗舰机已上市,我们断网实测了一周14B参数模型的本地推理。响应7.8秒、续航缩水三成、发热可控但持久战会降频。本文给出速度、功耗和隐私的真实数字,并对比云端API,明确判断普通用户当前是否值得为端侧
阅读全文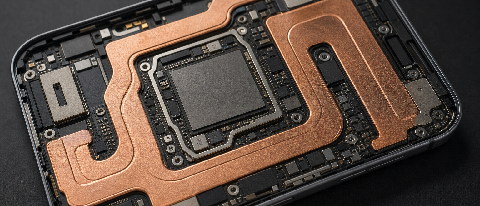 前沿研究
骁龙8 Gen5发布半年后,14B模型手机端落地遭遇散热与调度双重拷问。实测显示,INT4量化+NPU-CPU混合调度是稳态运行的关键,单纯堆砌算力无法解决热节流导致的掉帧。
阅读全文