7B到14B模型上手机,先过内存和功耗两道关
7B模型做INT4量化后,权重理论下限约3.5GB;14B约7GB,运行时还要给KV Cache、系统和后台应用留空间。手机NPU调度的重点,是控制上下文、算子回退和持续发热。
阅读全文关键词:INT4量化
7B模型做INT4量化后,权重理论下限约3.5GB;14B约7GB,运行时还要给KV Cache、系统和后台应用留空间。手机NPU调度的重点,是控制上下文、算子回退和持续发热。
阅读全文 技术应用
骁龙8 Gen 5手机实测显示,INT4量化32B模型运行十分钟后,生成速度从8 token/s跌至3 token/s。本文对比RTX Spark的45—80W主动散热与手机的被动极限,剖析内存墙与NPU架构的真实瓶颈,
阅读全文 前沿研究
24GB内存的骁龙8 Gen 5旗舰机,已经能本地运行INT4量化的Qwen-32B:首字2.1秒,起步约8 tokens/s。持续推理后,机身升至46°C、速度掉到3 tokens/s,12分钟耗电23%。30B上手机
阅读全文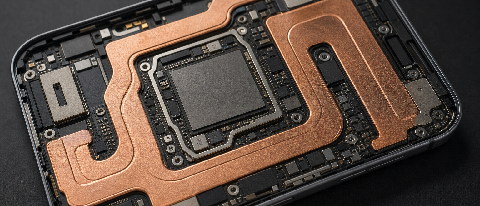 前沿研究
骁龙8 Gen5发布半年后,14B模型手机端落地遭遇散热与调度双重拷问。实测显示,INT4量化+NPU-CPU混合调度是稳态运行的关键,单纯堆砌算力无法解决热节流导致的掉帧。
阅读全文 前沿研究
骁龙8 Gen 5让14B端侧AI推理成为可能,但热节流让算力大打折扣。实测数据显示,INT4量化、NPU-CPU混合调度与内存预分配,比单纯堆砌NPU算力更能实现可持续运行,这才是2026年端侧AI落地的关键。
阅读全文 前沿研究
骁龙8 Gen 5让14B端侧大模型成为现实,但高负载引发的热节流是最大拦路虎。实测数据显示,INT4量化在维持稳定性上优于INT8。本文结合高通白皮书与最新工程实践,提供从量化选择、内存调度到动态降频的代码级优化方案,
阅读全文 技术应用
 前沿研究
DeepSeek-R3等推理模型确立云端智能标杆后,3B参数小模型正借助TinyML、稀疏化和INT4量化技术,下沉至智能手表等低功耗设备。本文拆解端侧推理如何实现健康监测与隐私保护的双重跃迁,并探讨其对企业FinOps
阅读全文 开发者生态
GPT-5.2 Pro和Gemini 3.1 Pro的API报价让不少团队头疼,但单纯比价已经不够了。Gartner预测2030年推理成本将降90%,开发者需要盯紧TPOT和KV Cache,并在FP8与INT4量化中找
阅读全文搭载M5芯片的iPad Pro首次在iPadOS 19上本地运行30B参数大模型,文档摘要延迟仅200毫秒,比云端快1.2-3秒。苹果通过INT4量化将模型压缩至15GB,配合16核神经网络引擎和翻倍的内存带宽实现这一突
阅读全文我们在iPhone 17 Pro上实测了Apple Intelligence 2.0。A19 Pro芯片用INT4量化让大模型本地跑,日常指令没问题,但复杂任务偶尔会算错。连续跑跨App任务后,手机很烫,性能就掉下来。现
阅读全文