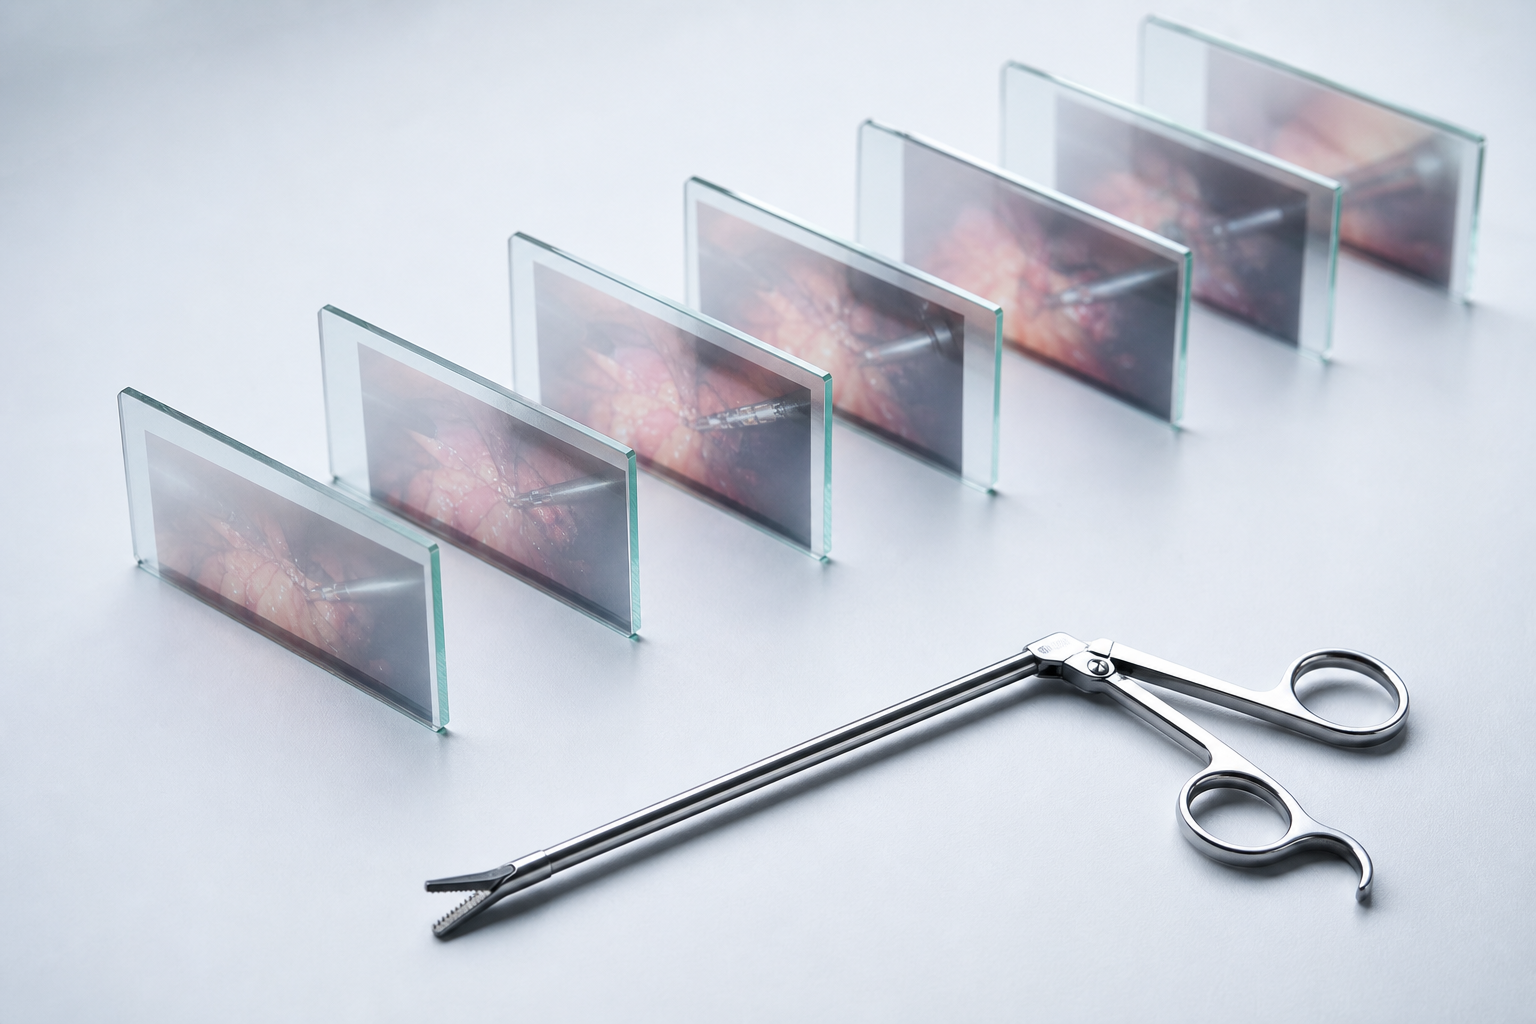
一段20分钟的腹腔镜胆囊切除术视频,按30fps计算,一共36,000帧。模型面对的并非36,000张彼此独立的图片:大量相邻帧几乎重复,少数关键动作却可能转瞬即逝。哪些画面可以丢,哪些必须保留,选择本身就决定了后面的判断有没有证据。
主流多模态大模型(MLLM)常以CLIP范式为基础,通过图像—文本对进行预训练。这套方法适合在单帧里对齐“手术刀”“胆囊管”等语义,但手术步骤依赖前后关系。放进1,200秒的流程后,同样的画面出现在不同阶段,含义可能完全不同。模型记住某一秒看到了什么,仍不等于它理解了整场手术。
每秒取一帧,可能正好漏掉证据
如果把采样率降到1fps,一段20分钟的视频只剩1,200帧,计算压力确实小了。可假设一次关键的血管结扎只落在30—60帧内,固定采样点就可能与这段动作完全错开。
另一条路是把36,000帧尽量完整地送入模型。问题随即反过来:大量重复画面占据视觉Token和显存,真正有用的短片段被淹没。上下文窗口再长,也无法找回采样阶段已经删除的证据,更不会自动理清步骤之间的因果关系。
所以,视频压缩并非无关紧要的前处理。采样器选中哪一帧,已经是推理链的一部分。
CliPPER先处理前后文
据《论文分享|多模态大模型最新进展》摘要,CliPPER关注的正是手术视频—语言理解中的标签稀缺和复杂时序,并设置了四种预训练目标来学习长时序与上下文关系。每一帧被放回前后文中训练,目标是让模型保留跨片段的信息,而非只完成单帧语义匹配。
标签问题仍绕不过去。给一段20分钟的视频标注手术名称相对容易,划出动作边界、步骤切换和逻辑节点,则需要外科专业知识。标签稀缺之外,还有粒度和专业性的限制。
这类任务需要的记忆也有层次:底层记录抓取、切割等局部动作;中层维护手术步骤,例如从“暴露胆囊”转到“分离胆囊管”;顶层再结合医学知识进行合规性判断。上下文窗口变长,只是扩充了容量,流程状态不会因此自动出现。
让模型先去找相关片段
香港理工大学在2025年6月发布了VideoMind的公开介绍。陈长汶教授团队通过多模态智能体处理长视频,并结合链式低秩适应策略,降低资源和算力消耗。
VideoMind面向的是通用长视频理解。它对手术视频更直接的启发,在于读取方式:模型可以围绕问题定位相关片段,再回看前后文,全部帧不必获得同等计算预算。长视频由此变成“先找证据,再核对上下文”的过程。
这提供了方法参照,不能直接视为临床验证。手术视频还多了一道要求:找到片段之后,模型必须说明判断发生在什么时间,并允许医生回到原始画面核查。
临床结论必须带时间坐标
假如模型给出“胆囊管已结扎”的判断,却把时间戳偏移了5秒,核查者看到的可能已经是另一段操作。文字结论看起来合理,证据位置却对不上,这是时序幻觉最难察觉的一种表现。
理想输出至少应接近这样的示意格式:
第452帧出现A动作;第890帧确认B状态;据此判断手术进入C步骤。
这条证据链同时回答了三个问题:模型看到了什么,证据出现在哪里,前后事件怎样支持结论。单一的综合准确率很容易掩盖时间定位错误,因此流程总结、事件定位和证据一致性需要分别核查。
遮挡和形变会暴露空间短板
《多模态大模型驱动的空间智能:技术进展、评估体系与未来挑战》指出,主流模型多基于CLIP式图像—文本预训练,缺少对几何结构和空间拓扑的显式建模。这个缺口放到手术视频里会更明显:器械遮挡、组织形变都可能改变局部外观,仅仅认出物体名称,无法说明解剖结构之间的相对关系。
UniMedVL项目页提出“观察—知识—分析”的统一路径,并指出单独的文本报告缺少空间定位,单独的视觉标注又缺少推理上下文。统一建模有助于减少这种碎片化,但它不会自动解决长视频的时间索引问题。模型即使掌握医学知识,也可能找不准证据出现的时刻。
到了手术室,延迟会重新筛选模型
术中预警还要面对功耗和实时性。对需要毫秒级响应的任务,云端回传本身就可能成为障碍。如果一个100B模型完成一次推理要花10秒,它很难承担术中实时提示;转向端侧部署,又会遇到功耗、散热和算力限制。
首字延迟(TTFT)和持续生成速度在这里并非附属指标。实验室里可以接受的等待时间,进入手术流程后可能立即失去意义。
36,000帧需要压缩,30—60帧的关键动作不能漏,前后步骤要连成医学因果链,空间关系和时间证据还得经得起复核。这些要求又必须放进手术室的功耗与延迟预算里。
眼下更稳妥的定位,是把这类模型优先用于视频检索、术后复盘和辅助标注。认出器械只是起点。只要一句判断还落不到具体帧上,模型就不该站到术中决策的位置。