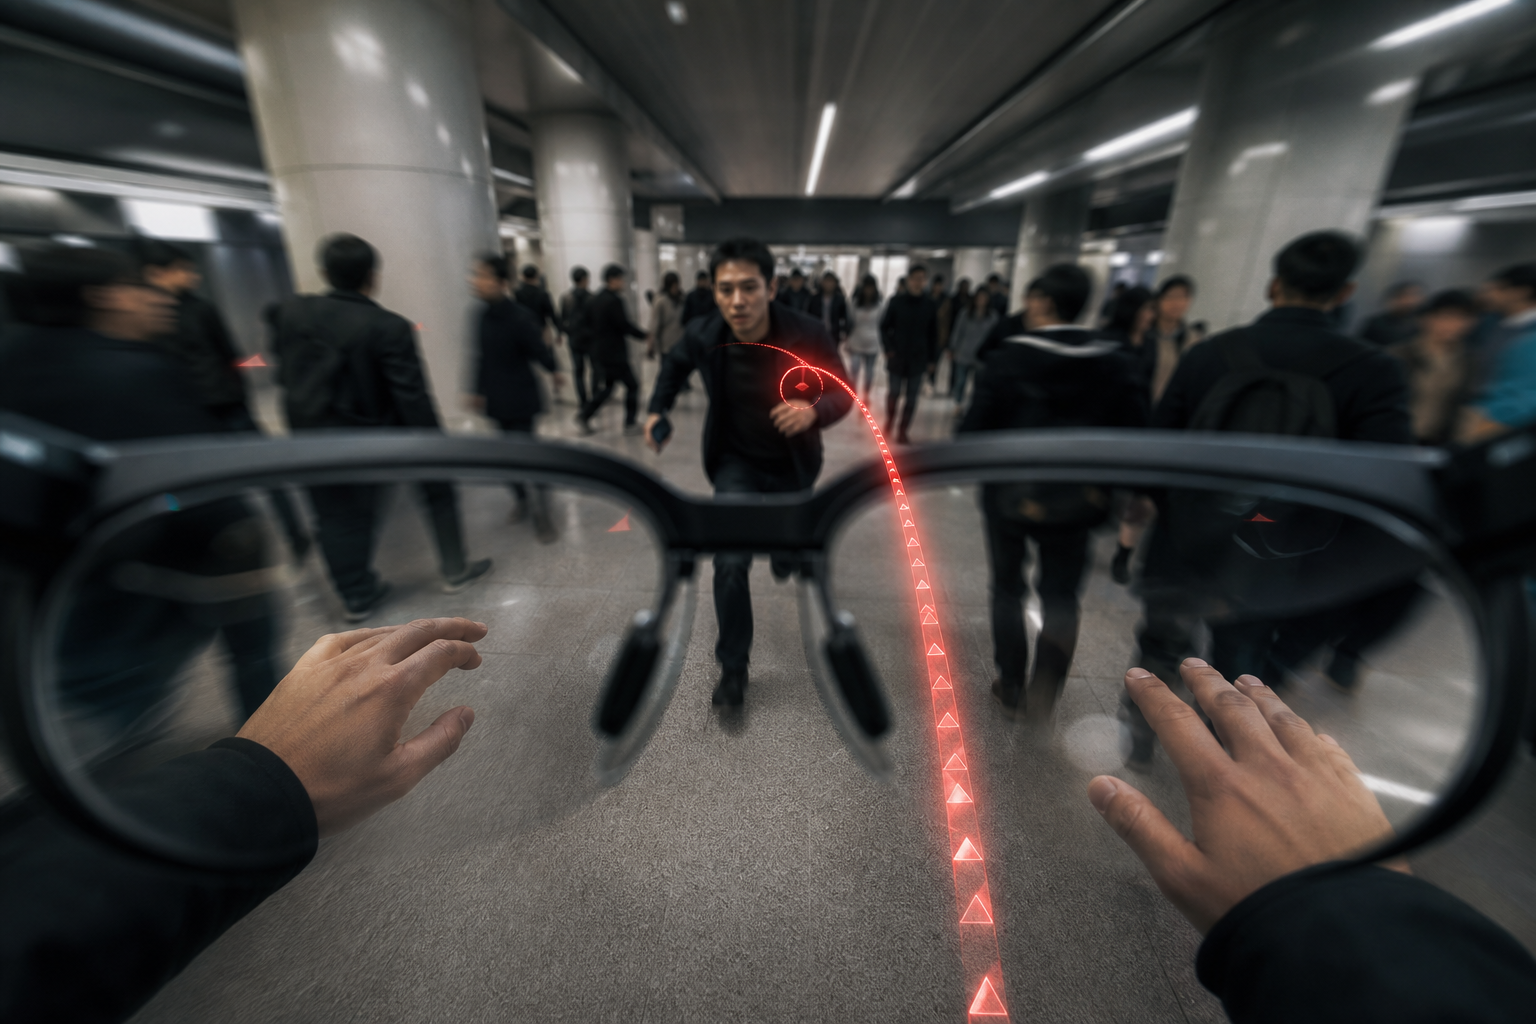
在 2026 年的早高峰地铁站,一个戴着 AI 眼镜的行人正低头看虚拟导航,前方一名奔跑的乘客突然由于打滑向其倾斜。在碰撞发生前的 300 毫秒,眼镜的镜片边缘闪过一道淡红色的预警线条,并伴随一个轻微的触感震动。用户下意识向左侧闪避,成功避开了这次冲撞。
这不再是简单的“视觉识别”——识别出前方有一个“人”并报出名称,而是真正的“物理预测”。AI 眼镜通过本地运行的世界模型,在潜空间内模拟了对方的运动轨迹与物理惯性,得出了“即将碰撞”的结论。这种从“看到什么”到“将发生什么”的跨越,标志着端侧世界模型正式进入实用化阶段。
从 VLM 到世界模型:认知的升维
过去两年,大多数 AI 眼镜依赖的是 VLM(视觉语言模型)。当你问“我面前是什么”时,模型会将图像编码为 Token,交给云端或本地的小模型,最后输出一段文本。这种模式的本质是“打标签”,它对物理世界的理解是静态的,缺乏对时间轴和因果律的感知。
而 2026 年端侧模型演进的核心是“世界模型(World Model)”。根据谷歌近期披露的研发方向,其正押注通过空间感知与环境预测技术,试图让 AI 眼镜具备某种程度的“物理直觉”。这意味着模型不再仅仅在预测下一个 Token,而是在预测下一个“状态”。
这种能力在物理 AI 的闭环中至关重要。正如我们在《大模型长出“手脚”后,物理AI要先学会什么》中所分析的,物理 AI 必须补齐“感知 $\rightarrow$ 预测 $\rightarrow$ 执行 $\rightarrow$ 纠错”的链路。对于 AI 眼镜而言,它虽然没有“手脚”去执行动作,但它的“执行”体现在对用户的实时提醒上。如果预测延迟超过 500 毫秒,这种预警就失去了物理意义,因为人类的反应时间与物理碰撞的速度一样快。
3B 模型的“慢思考”与毫秒级推理
要在镜腿那么小的空间里跑通世界模型,算力与功耗是死结。在 37℃ 的户外环境下,即便是不跑复杂模型的 AI 眼镜,镜腿温度也能迅速攀升至 46.2℃,电量掉速惊人(参考此前对三款 AI 眼镜的高温实测)。在这种极端约束下,无脑堆参数量完全不可行。
目前行业达成的一个共识是:端侧不需要万亿参数,而需要一个高效的 3B 级模型。在 MWC 2026 上,搭载第一代骁龙 AR1 的千问 AI 眼镜(Qwen Glasses)S1/G1 系列展示了这种可能性——通过将优化后的 Qwen 模型部署在本地,实现了无需联网的实时响应。
但简单的量化压缩不足以支撑物理预测。真正的突破在于引入了类似 GRPO 算法和轻量级 MCTS(蒙特卡洛树搜索)的“慢思考”机制。正如《3B模型跑强化学习:为什么端侧慢思考比无脑堆参数更省电》中所探讨的,通过在本地进行少量的轨迹采样和验证,3B 模型可以在不增加参数量的情况下,显著提升对复杂物理场景的推理成功率,同时将能效比提升近三分之二。
对于物理碰撞预测,模型不再尝试生成一段精美的描述,而是输出一个轻量级的物理状态向量。这个过程将推理时延压缩到了 100 毫秒以内,使得“毫秒级预判”成为了可能。
硬件支撑:从 Robot Phone 到 Atlas 950
世界模型的训练需要海量的物理仿真数据,而部署则依赖极强的端侧算力。2026 年的硬件趋势呈现出一种有趣的“两极分化”。
一极是极致的端侧集成。在 MWC 2026 上,荣耀推出的 Robot Phone 将三轴机械防抖云台与 2 亿像素传感器结合,虽然它是手机,但其搭载的自动跟踪和锁定焦点技术,实际上是世界模型在微型硬件上的预演——它需要预测被摄主体的移动路径,从而驱动微型电机进行补偿。
另一极是恐怖的训练基座。在 2026 世界人工智能大会(WAIC)上,华为 Atlas 950 等超节点设备的亮相,为 MiniMax M3 等多模态大模型的迭代提供了算力支撑。这些在云端通过数万亿 Token 学习过物理规律的模型,在经过蒸馏和量化后,才能够被“塞进”像三星与谷歌合作研发的 AI 眼镜中。
然而,硬件的升级并非没有代价。随着端侧模型能力的增强,厂商们正撞上新的墙。一方面是功耗带来的散热压力,另一方面则是专利壁垒。正如《AI眼镜刚热起来,光波导已撞上出海专利关》所提到的,即便你解决了物理预测的算法问题,如果光波导的量产结构触碰了美国 INGENIOSPEC 等公司的专利,产品依然无法全球化。
物理预判将如何重构人机交互?
当 AI 眼镜能够预测物理碰撞,它将从一个“随身翻译机”或“信息显示屏”,变成一个“数字守护神”。
这种能力的实际应用场景将远超避障:
- 精细化辅助:对于视障人士,世界模型可以预测路边车辆的行驶趋势,而非仅仅告知“前方有车”,从而提供更安全的过马路建议。
- 工业远程协作:在维修复杂设备时,眼镜可以预判操作员的手势是否会导致零件碰撞,在错误发生前发出警告。
- 体育训练:在网球或乒乓球运动中,实时预测球的落点并将其以视觉引导线形式呈现在镜片上。
当然,我们必须意识到,端侧世界模型目前仍处于“感知 $\rightarrow$ 预测”的早期阶段。它能告诉你“可能会撞”,但还不能像成熟的 L3 级自动驾驶那样接管控制权(参考《自动驾驶L3级合规元年:百度萝卜快跑与特斯拉FSD的路权博弈》中的责任界定逻辑)。在穿戴设备上,这种预测依然是以“建议”而非“强制执行”的形式存在。
结语
2026 年是 AI 从“数字世界”向“物理世界”大规模迁移的元年。当世界模型在手机端跑通,并在 AI 眼镜上实现实时物理预测,这意味着 AI 终于开始理解质量、惯性、速度和碰撞这些基础物理常识。
未来的竞争不再是谁的模型参数更多,而是谁能在 3B 规模的参数量下,让设备在不发烫的前提下,比人类更快地预判出物理世界的下一个瞬间。