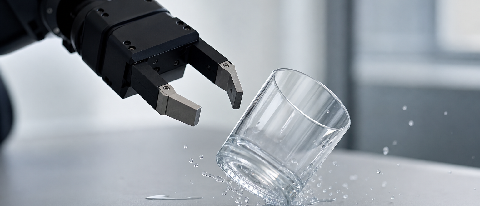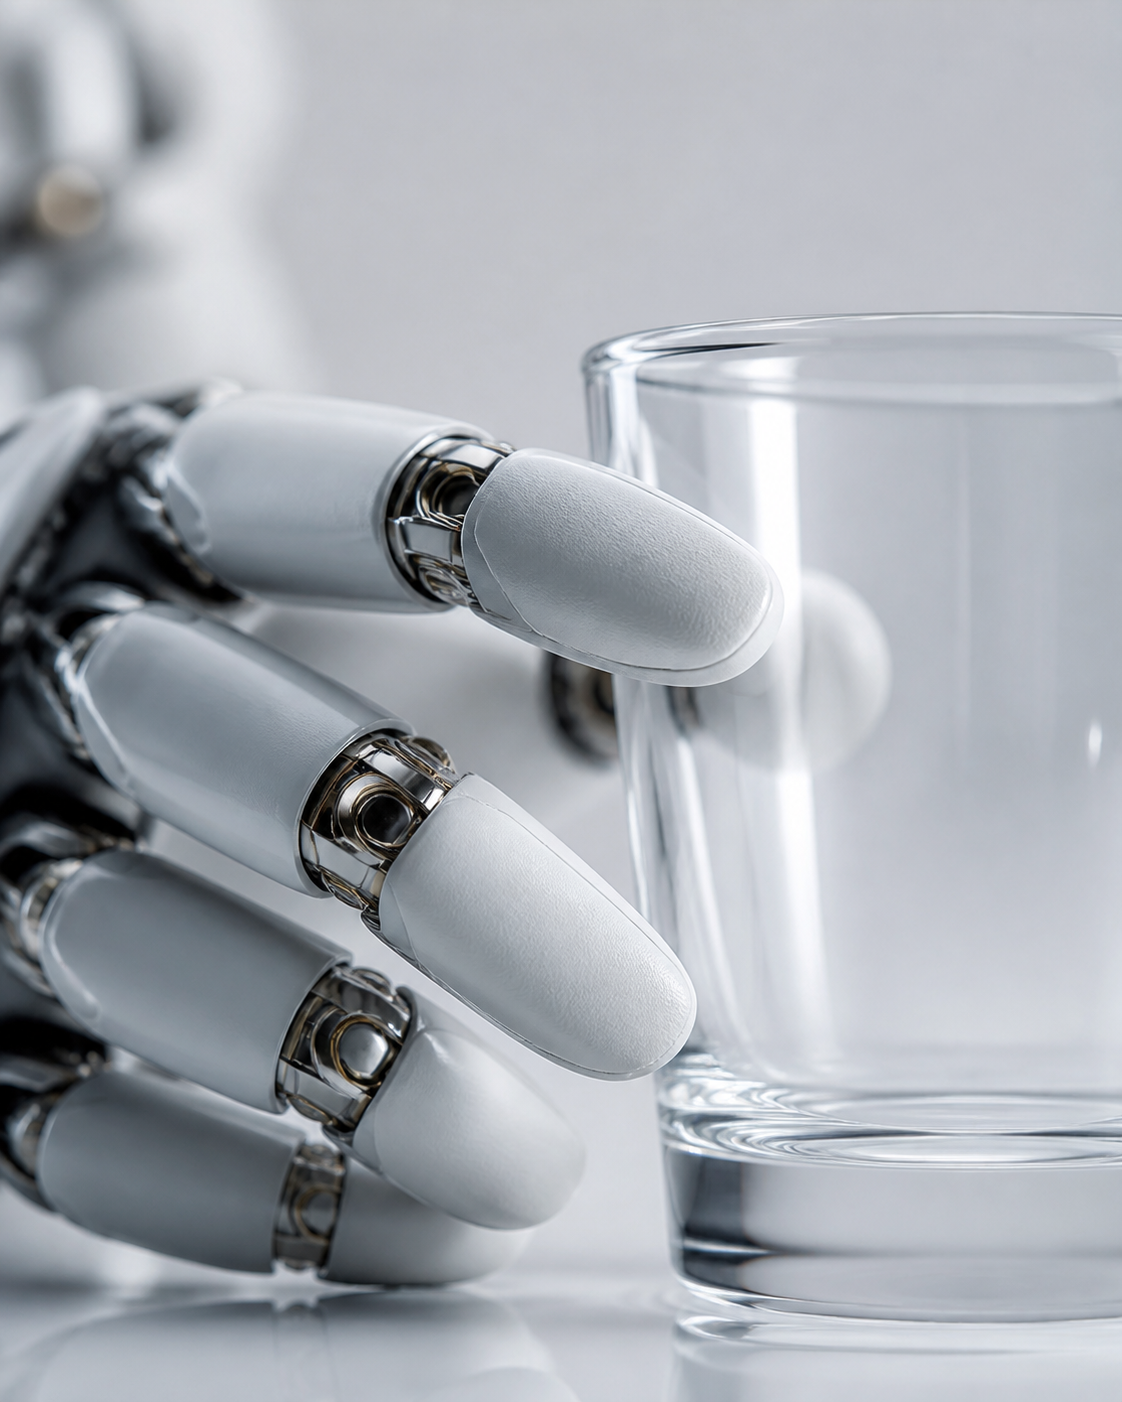
一个透明玻璃杯和一个外形相近的塑料杯摆在桌上。相机可以先找位置、看轮廓。抓取开始后,问题变了:手指碰没碰到杯壁?力是否合适?杯子有没有往下滑?这些接触中的变化,单靠画面很难处理。
所以,机器人触觉的价值不止于“分辨材质”。它更重要的用途,是在动作进行时提供校正信号。
多出来的“T”,得管动作
网易报道提到,一支由9位清华博士组成的团队以“具身本能”跑通工业产线。报道还谈到一条值得关注的技术路径:从 VLA(Vision-Language-Action,视觉-语言-动作)走向 VTLA(Vision-Tactile-Language-Action,视觉-触觉-语言-动作)。
看起来只是多了一个字母,落到机器人身上却很具体。视觉告诉系统目标在哪里,触觉补上接触之后发生了什么。看见物体,解决的是动手前的问题;摸到以后该继续、调整还是停下,才决定动作能不能做稳。
公开摘要没有展开“具身本能”的具体模型结构,因此不能把它直接解释成某一种固定算法。能够确认的是,这支团队把触觉放进了精细物理交互和工业产线,而不是只拿它做材质分类。
ReSkin 先补上接触这条信号
Meta 的 ReSkin 提供了另一条技术路线。据《AI日报头条》的节目摘要,ReSkin 是一款人造皮肤,使用磁感应和自监督学习,让机器人感知触摸到的物体。
这里要收住结论。现有摘要没有给出材质识别精度、数据规模或工业验证结果,不能据此推断 ReSkin 已经能在各种环境中稳定区分所有材质。它首先解决的是“获得触觉信号”,至于信号能否及时转成可靠动作,还要看后续的模型和控制系统。
能摸到,只是起点。
线束产线比材质问答更难
线束是检验触觉能力的直接场景。线缆会弯、会偏,抓取和插接时还可能遮挡相机。视觉适合寻找位置,但接触是否正确、动作是否需要调整,不能一直依赖预设轨迹。
中国机械工业联合会机经网的栏目预告提到,它石智航将让 AWE 3.5 驱动的真实线束产线亮相 WAIC 2026,并把产线搬到现场。这个案例的价值,在于给触觉控制提供了一个足够具体的考场。
预告不是结果。公开页面尚未给出成功率、作业节拍或纠错延迟等信息。现场更值得看的,是位置发生变化后能否调整,接触异常时能否停下或回退,以及连续操作是否稳定。现阶段,AWE 3.5 更适合作为待观察的工业样本,而不是触觉问题已经解决的证明。
触觉装上去,还要和视觉对得上
腾讯新闻刊发的《瞭望中国式创新》报道显示,戴盟于2023年正式运营,主攻触觉感知与灵巧操作。至少在这家公司身上,触觉不是附属功能,而是研发主线。
但传感器多,不等于机器人就更灵巧。图像和接触信号并不是同一种信息:视觉持续提供画面,触觉通常要等到接触发生后才出现;相机还可能被遮挡,机器人经常只能拿到部分输入。
《机器人产业真正兴起的曙光(下)》介绍的 Quintet AI 机器人世界模型工作流,重点正是融合多种传感器模态,并允许系统接收部分输入。这比简单增加传感器更接近实际工况:信息不完整时,机器人仍要决定下一步怎么做。
别急着把触觉写成万能答案
医疗手术机器人常被列为触觉的潜在应用。接触反馈如果能传到操纵端,理论上有助于更细致地控制动作;但现有来源没有提供具体产品、实验或临床数据,不能写成已经落地的突破。
家庭场景也一样。无论是 Figure、Optimus,还是优必选相关产品,要处理衣物、杯子和易碎物品,评判标准都不该只是完成一次演示。接触条件改变后,动作能否及时调整,才更接近真实使用。现有素材没有横向触觉指标,因此也无法据此判断谁已经领先。
从 VLA 到 VTLA,关键变化不在缩写,而在控制方式:机器人要在碰到真实世界后继续判断。ReSkin 提供人造皮肤,“具身本能”强调物理交互中的动作策略,AWE 3.5 把问题带到线束产线,Quintet AI 则处理多模态输入。它们还不是同一套成熟答案,但评判标准已经变得更实际——机器人能不能根据接触反馈,把下一步做对。