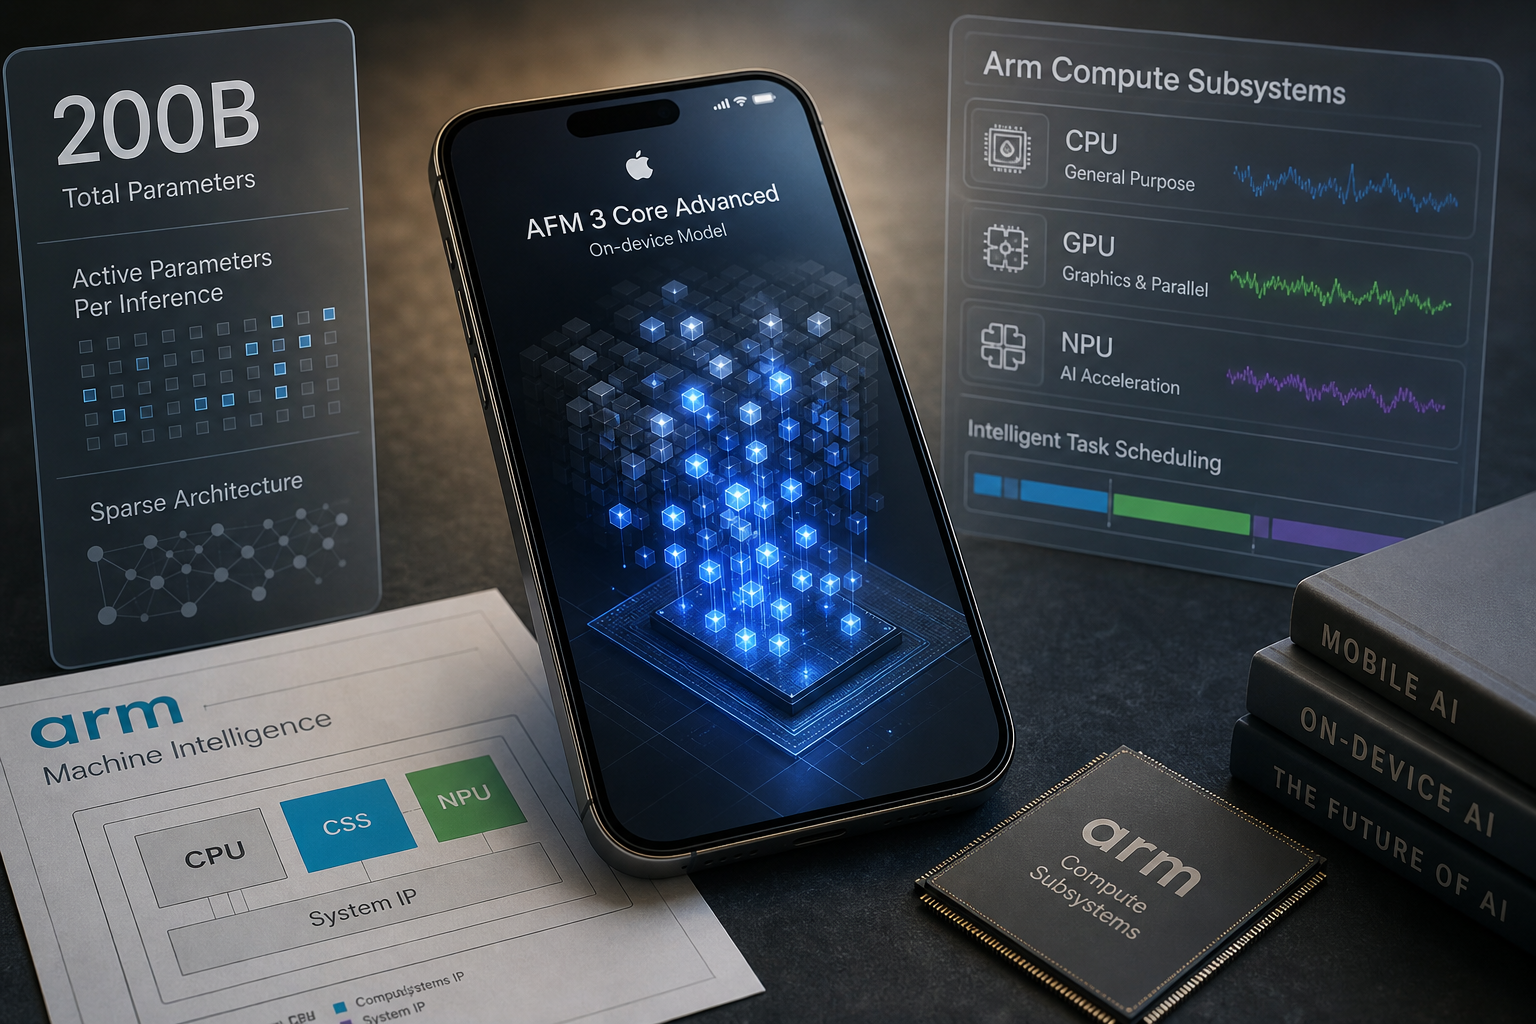
苹果把端侧模型做到了约200亿参数,但手机并不需要在每次推理时调用全部参数。
据《21世纪经济报道》2026年6月23日报道,苹果端侧主力模型AFM 3 Core Advanced采用稀疏架构,每次推理只激活其中一部分参数。Google的Gemini Nano则由更大的Gemini模型蒸馏而来,同样把重点放在端侧可部署性上。
这两条路线给手机厂商提了个醒:模型参数量仍然重要,但已经不能单独决定部署效果。真正落到手机上,还要看一次推理调用多少参数、芯片能否有效执行,以及任务该交给CPU、GPU还是NPU。
Arm公开的移动端AI资料也在强调同一件事。随着模型演进速度开始领先于硬件,优化对象已经扩展到整个计算栈。Arm提供CPU、CSS和IP产品组合,并把移动端AI放在从云端到边缘侧的部署链条中考虑。安谋科技发布的《AI处理的未来》相关介绍,则将下一阶段的重点概括为多元算力融合。
对手机端侧模型选型来说,需要重算的主要有四笔账。
参数总量之外,更要看实际激活量
AFM 3 Core Advanced最值得关注的地方,不只是约200亿参数,而是稀疏激活。
稠密模型通常会在推理时调用大部分参数,模型越大,对计算、内存和功耗的压力越直接。稀疏架构则允许模型保留更大的容量,同时只激活与当前任务相关的一部分参数。这样一来,标称参数量和单次推理成本不再简单对应。
手机厂商比较模型时,首先要问的也就不该只是“模型有多大”,还要问“每次到底运行多少”。如果模型采用稀疏架构,还需确认芯片和部署工具是否支持对应的稀疏模式。缺少软硬件适配,理论上减少的计算量未必能转化为实际速度和功耗收益。
因此,稀疏模型的评估不能停留在模型文件或参数表上。实际激活量、运行延迟、内存访问和持续功耗,都要在目标设备上测。
量化不能只看压缩后的位宽
端侧部署通常要通过量化降低模型的存储和计算成本,但位宽更低,不等于最终体验一定更好。
不同模型结构、不同网络层对精度变化的敏感程度并不一致。模型经过压缩后能否保持可用效果,还与芯片支持的计算格式、算子覆盖和部署工具有关。尤其当一个模型需要在多个计算单元之间执行时,格式转换与数据搬运也会产生额外开销。
Arm在移动端AI页面中将CPU、CSS和IP放在一套计算平台内介绍,说明端侧推理已经很难被理解成某个单一处理器的工作。选型时除了比较量化后的模型大小,还要检查目标硬件能否直接运行关键算子,以及模型转换过程中是否出现回退执行。
一个模型即使压缩得足够小,如果部分算子无法在预定计算单元上运行,实际延迟仍可能失控。相比只记录INT8或其他精度标签,逐层检查算子落点和转换成本更有价值。
CPU、GPU和NPU的分工要按任务来定
过去谈手机AI,讨论往往集中在NPU性能。但真实使用中的任务差别很大:有些请求短而频繁,有些任务计算量更重,还有些功能需要长期在后台运行。
Arm的移动端AI资料明确提到基于CPU的AI推理,同时也提供覆盖CPU及其他IP的产品组合。这意味着,端侧任务未必都要交给同一个计算单元。模型放在哪里运行,应由调用频率、响应要求、功耗和算子适配共同决定。
输入、搜索、翻译等功能看起来都属于端侧AI,负载特征却未必相同。启动成本、数据搬运和任务持续时间,都可能改变最终选择。对短任务来说,调用专用单元是否划算,需要实测;对计算更重的任务,则要评估多个计算单元协同时产生的调度成本。
这里最容易被忽略的是切换开销。模型如果频繁跨CPU、GPU和NPU执行,纸面算力未必能顺利转化为端到端速度。厂商需要记录每个算子的实际执行位置,并观察跨单元数据传输是否拖慢整条链路。
内存访问可能比峰值算力更早碰到上限
模型规模扩大后,压力不只落在计算单元上。权重加载、中间结果保存和不同处理器之间的数据传输,都要占用内存带宽。
稀疏架构可以减少实际参与计算的参数,但是否同步减少内存访问,还取决于权重组织方式和运行时实现。混合部署也有类似问题:CPU、GPU和NPU协同执行时,如果数据频繁往返,带宽与延迟成本可能抵消部分计算收益。
这也是为什么手机端侧选型不能只比较峰值TOPS。峰值指标描述的是特定条件下的计算能力,用户最终感受到的却是完整任务的响应速度、发热和续航变化。
工程测试中应同时观察模型加载时间、推理过程中的内存读写、跨计算单元的数据搬运,以及连续运行后的性能变化。这些结果比单次跑分更接近真实使用。
选型表里至少补上四项
结合苹果的稀疏模型路线,以及Arm对整个计算栈和多元算力融合的强调,手机端侧模型评估可以补上四项:
- 实际激活量:一次推理调用多少参数,硬件是否支持模型采用的稀疏方式。
- 算子与精度适配:量化后能否保持效果,关键算子会不会回退到其他计算单元。
- 异构调度成本:CPU、GPU和NPU之间切换时,需要付出多少数据搬运和等待时间。
- 内存访问压力:权重、中间结果和上下文对带宽、容量及功耗的实际占用。
这些项目很难只凭芯片发布会或模型参数表判断,最终仍要在工程样机上验证。测试也不能只跑一次,而要放进相册搜索、输入联想、翻译等具体场景,观察延迟、发热和续航是否稳定。
AFM 3 Core Advanced把参数规模推到约200亿,并不意味着手机端侧选型从此只比谁的模型更大。它更像是在提醒行业:模型容量、单次计算量和设备成本已经可以被拆开讨论。
Arm强调的多元算力融合,则把问题进一步推向部署层。CPU、GPU和NPU各自更强固然重要,但模型能否按任务特点落到合适的计算单元上,才决定这些硬件能力最后能兑现多少。