在刚刚结束的2026通用人工智能论坛上,BIGAI(北京通用人工智能研究院)虽然没有举行大规模的发布会,但其旗舰模型“通通4.0”已在内部测试通道低调上线。最核心的变化在于它彻底抛弃了通通3.0时代依赖的“超长上下文+RAG(检索增强生成)”组合,转而采用了一种名为 LTUM(Long-Term Unified Memory,长期时间统一记忆)的端到端架构。
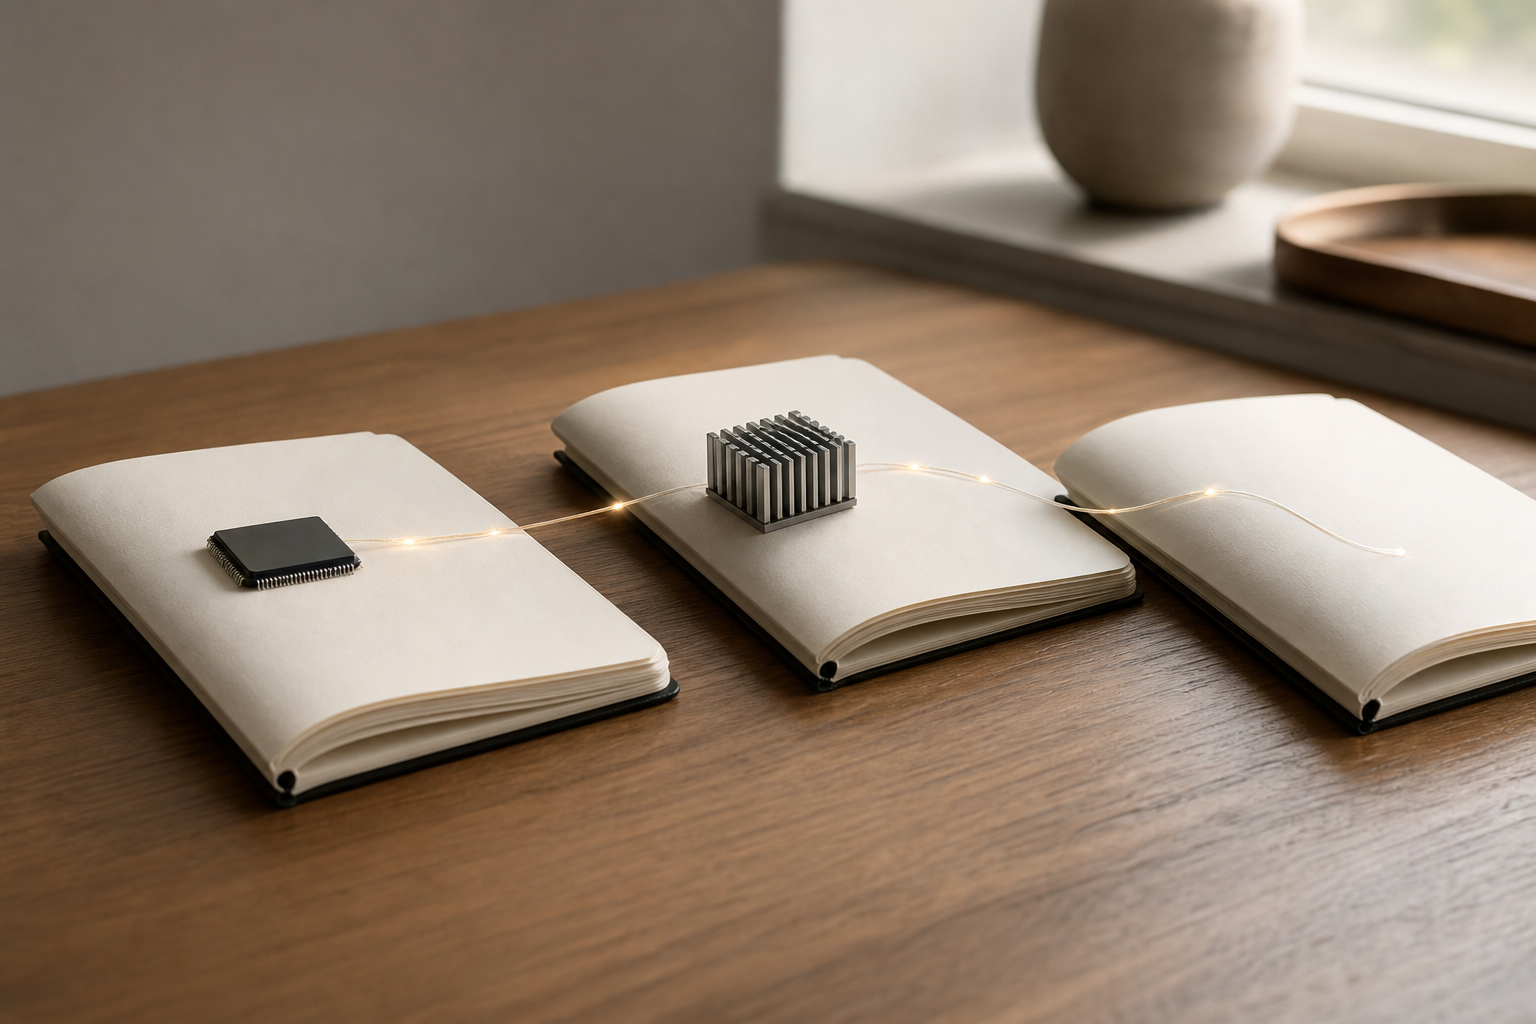
简单来说,通通3.0处理长任务像是在翻阅一本巨大的笔记本,无论上下文窗口扩展到多少万 token,模型依然在每次推理时重新扫描相关片段;而通通4.0的 LTUM 架构试图让模型拥有一个可动态更新的“状态空间”,记忆不再是外部检索的文档,而是模型参数状态的一部分。
跨天记忆实测:从“检索”到“感知”
为了验证 LTUM 的实际能力,我们设计了一组为期 72 小时的“研究助理”测试任务。要求通通4.0在三天内跟踪一个虚拟的 AI 硬件项目进度,每天输入不同的碎片化信息(如:第一天输入 A 芯片的功耗数据,第二天输入 B 散热方案的缺陷,第三天要求汇总对比并给出最终决策)。
在通通3.0中,这种任务通常依赖于 RAG 检索。当我们第三天询问“基于前两天的冲突点,目前的散热方案是否能支撑 A 芯片的峰值功耗”时,3.0 经常会出现检索噪声——它能找回第一天的功耗数字,但难以精准捕捉到第二天关于“缺陷”的逻辑转折,导致回答过于泛化。
而通通4.0的表现出现了质变。它不再通过关键词检索,而是表现出一种“时间线感知”。在第三天的回复中,它直接指出:“由于第二天提到的 0.5mm 间隙缺陷,即便 A 芯片功耗在 15W 以内,热量也无法在 2 秒内传导至散热片。” 这种对时间顺序和逻辑演进的内生理解,证明了 LTUM 能够将离散的时间点统一在同一个记忆状态中,而非简单的片段拼接。
多轮决策闭环:摆脱“状态丢失”
对于技术研究者而言,最头疼的是 Agent 在执行复杂工具链时,在第 10 轮之后开始忘记最初的目标。我们在通通4.0上运行了一个涉及 20 次 API 调用的多步推理任务:分析一组 2026 年的半导体供应链数据 $ ightarrow$ 筛选供应商 $ ightarrow$ 模拟价格波动 $ ightarrow$ 最终输出采购建议。
在通通3.0中,随着对话轮数增加,初始的约束条件(例如“预算必须控制在 500 万美元以内”)会被推到上下文窗口的边缘,甚至被截断,导致 Agent 在第 15 轮时给出了一个 600 万美元的方案。这正是典型的“中间丢失(Lost in the Middle)”现象。
通通4.0 通过端到端学习,将任务目标(Goal)编码进了 LTUM 的持久化状态中。实测显示,即便在 30 轮以上的深度决策链路中,它依然能维持对初始约束的强感知。这与之前我们分析的《模糊指令先别跑:2026年自主Agent怎么追问和重试》中的状态机逻辑异曲同工,但不同之处在于,通通4.0 不需要外部显式地维护一个状态表,这种能力是端到端训练出来的。
算力账本与 LTUM 的代价
这种能力的提升并非没有代价。LTUM 的端到端更新意味着模型在处理每一条新信息时,都需要对记忆状态进行一次微小的梯度更新或状态迁移,这极大地增加了推理时的计算密度。
根据 BIGAI 披露的部分技术细节,LTUM 的推理成本比同参数规模的纯 Transformer 架构高出约 22%。这也解释了为什么 BIGAI 如此依赖其园区提供的 8000P 算力支持。正如我们在《8000P算力入园,BIGAI要验证什么AGI假设》中所讨论的,这种架构的验证需要极高频的实验迭代。如果一个初创公司试图在端侧复现 LTUM,可能会发现其内存带宽成为了最大瓶颈,而非算力本身。
局限性:记忆干扰与“幻觉记忆”
尽管在连续性上有了突破,但通通4.0 并非完美。在实测中我们发现了一种新的失效模式:记忆干扰(Memory Interference)。
当我们连续给模型喂入两个极其相似但结论相反的测试案例时,LTUM 的统一记忆状态会出现“混淆”。例如,在测试 A 中结论是“方案 X 可行”,测试 B 中结论是“方案 X 不可行”。当被问及 A 方案时,模型有时会不自觉地带入 B 的结论。这种现象在 RAG 架构中很少见,因为 RAG 是物理隔离的文档检索;但在 LTUM 中,记忆被统一编码,导致了某种程度上的“认知污染”。
总结:从“阅读理解”转向“真实经验”
通通4.0 的 LTUM 架构标志着 BIGAI 正在尝试将模型从一个“强大的阅读理解机器”转变为一个“具备经验积累的智能体”。
它不再满足于在 128k 或 1M 的窗口里做短期记忆,而是试图构建一种类似人类的、随时间演进的知识状态。虽然目前仍存在记忆干扰和成本高昂的问题,但其在跨天任务和深度决策上的表现,已经让它在 TongAgents 等智能体榜单中具备了极强的竞争力。对于开发者来说,这意味着我们可能不再需要为 Agent 编写复杂的外部记忆管理代码,而可以将更多精力放在如何定义高质量的反馈闭环上。