把BIGAI放到世界模型这条线上看,关键不在于又追了一个热词,而是机器人能力的判断标准变了。
过去看具身智能,问题往往很直接:杯子抓起来了吗?门打开了吗?路线走通了吗?这些指标仍然重要,但世界模型把问题提前了一步:动作发生之前,系统能不能预判环境会怎样变化。
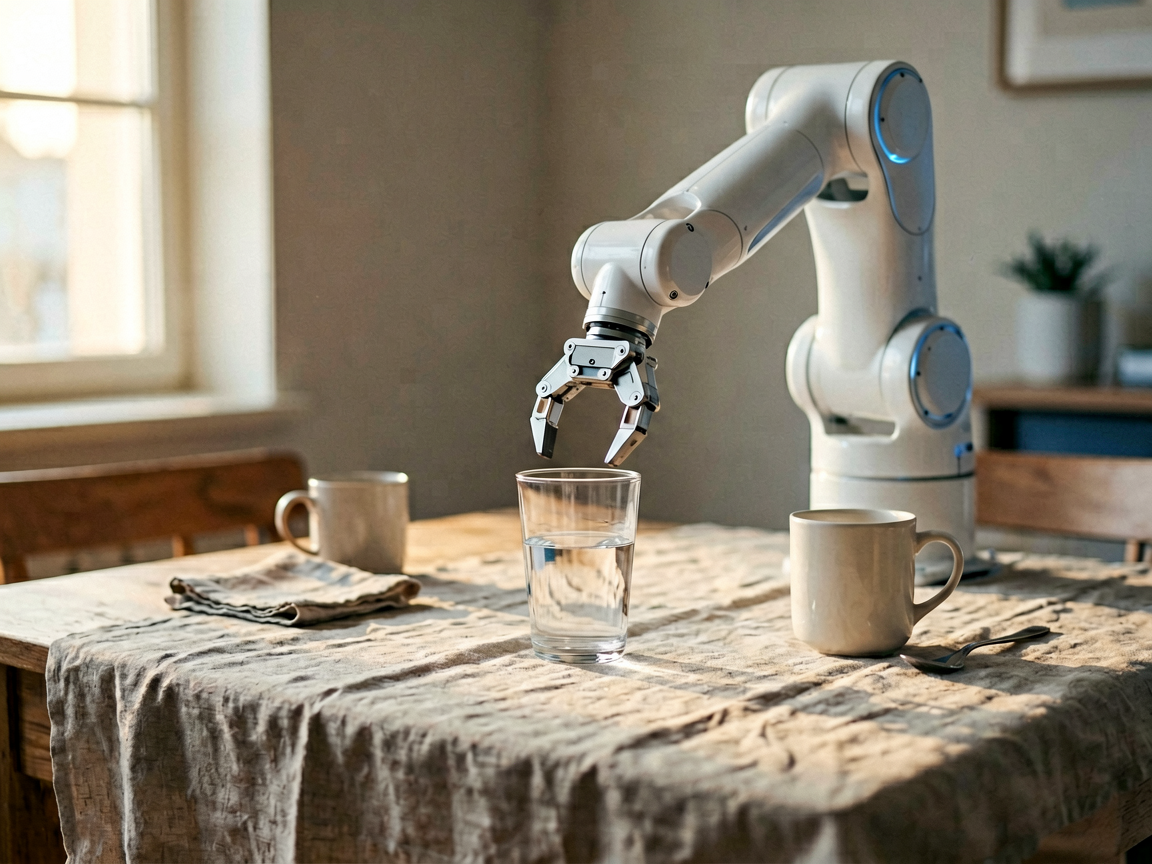
这不是文字游戏。机器人面对桌布、玻璃杯、液体、遮挡物时,单纯执行指令很容易失手。具备世界模型的系统,至少要尝试回答几个问题:推一下会不会带倒杯子?拿起物体后重心会不会变?倒水时液体状态会怎样变化?
所以,BIGAI押注世界模型,真正改动的不是宣传口径,而是具身智能的路线图:机器人不能只理解任务,还要能预测世界。
世界模型被推到台前
世界模型并不是新概念,但在2025年至2026年,它明显进入了产业讨论的中心。
财联社在2025年9月29日的报道中提到,人工智能先驱们几乎一致认为,世界模型对打造下一代人工智能正变得重要。报道还写到,李飞飞创立的世界模型初创公司 World Labs 已筹集2.3亿美元,方向指向空间智能和世界模型。
到2026年3月,硅谷101发布了一期关于世界模型的视频,把它放进“AGI的更近一步”这一语境下讨论。视频摘要里提到,随着大语言模型 Scaling Law 面临质疑,Yann LeCun、李飞飞以及 OpenAI、谷歌等都在追问:AI要想真正智能,能否“预测世界”是不是必须项。
清华大学电子工程系城市科学与计算研究中心发布的具身世界模型综述,也给了这个方向更系统的表达。FIB-LAB 信息显示,这篇综述从模型架构、训练方法、应用场景和评估体系等维度,对 Embodied World Models 做了梳理,并把它放进通用智能体的发展路线里讨论。
这些信号叠在一起,说明世界模型已经不只是研究者之间的术语。它正在进入机器人、物理AI和通用智能体的底层能力讨论。
评估先被改写
如果BIGAI把更多资源投向世界模型,最先变化的会是评估方式。
传统具身智能评测通常看任务结果。机器人完成抓取,算成功;没有完成,算失败。这种方式直观,也适合工程验收。但它会掩盖一个问题:机器人到底理解了物理变化,还是只在相似场景里复现了训练数据中的动作?
世界模型要求系统在行动前做预测。比如机器人看到桌面上有杯子和苹果,准备拿起苹果时,它需要估计杯子会不会被碰倒,桌布会不会被拉动,物体位置会不会改变。这里考察的不只是动作输出,还有对动作后果的模拟。
清华综述提到,世界模型旨在为智能体构建环境状态表示,并预测环境的动态变化。放到机器人评测里,问题就不能只停在“做没做成”,还要看系统能否预判物理过程。
这会让指标变得更难。任务成功率仍然要看,但不够了。预测误差、状态变化判断、长期规划中的因果关系,都可能成为新的评估重点。
对BIGAI来说,直接影响是:实验室不能只堆机器人执行数据,还要关心这些数据能不能帮助模型学习物理规律。
数据的重点变了
过去几年,VLA路线很容易被概括成 Vision、Language、Action:视觉输入、语言理解、动作输出。它的好处是链条清楚,工程实现直接,也便于把大模型能力迁移到机器人上。
但在真实物理交互里,VLA会碰到边界。语言很难完整描述摩擦、惯性、柔性材料、遮挡后的力反馈。视觉也不总可靠,尤其是在家庭或复杂工厂环境中,很多关键状态并不会完整出现在画面里。
世界模型要补的就是这一块。它需要的数据,不只是“人在什么情况下做了什么动作”,还包括动作之后环境怎样变化。倒水这个动作,重要的不只是手臂轨迹,还有容器形状、水位、倾倒角度,以及液体状态随时间的变化。
SEER Robotics 在讨论世界模型与 VLA 的文章中提到,NVIDIA 在 GTC 上持续推进 Cosmos、GR00T、Physical AI Data Factory 等技术栈,也让世界模型成为具身智能领域绕不开的关键词。这里释放出的信号很清楚:物理交互数据不足,正在被视为机器人基础能力的瓶颈。
Yang Li 的 World Model 入门文章还提醒了另一个问题:现在很多公司都说自己在做世界模型,视频生成、自动驾驶、机器人、3D生成、强化学习、VLA、物理仿真都被塞进同一个词里。大家说的是同一个词,但未必在做同一件事。
这对BIGAI很重要。路线转向世界模型后,不能只问“有没有模型”,还要问模型到底预测什么:像素、状态、动作后果,还是更抽象的因果结构。答案不同,数据采集方式和训练成本都会跟着变。
VLA的位置会被重新安排
把世界模型和VLA写成简单对立,容易误判。
更可能出现的是分工:VLA继续承担感知、语言指令理解和动作接口;世界模型在动作发生前模拟可能后果。机器人听到指令后,不是马上执行,而是在内部推演几种结果,再选择风险更低、成功率更高的动作。
硅谷101在2026年3月的视频摘要里提到,世界模型讨论涉及核心定义、三层研发结构和多条技术路线。这个分层思路放到具身智能里,可以理解为:底层处理感知和状态表示,中间层做动态预测,顶层再进行任务规划。
如果BIGAI沿这个方向推进,认知架构也不一定会被丢掉。更合理的调整是重新分工:世界模型回答“如果这么做,世界会怎样变化”;认知架构回答“我希望世界变成什么样”。一个偏预测,一个偏目标和决策。
这比单纯强调“机器人理解任务”更接近真实场景。拿杯子、倒水、整理桌面,都不是一句指令就能完成的动作。机器人需要连续反馈,也需要随时判断:现在这个状态,下一步还能不能照原计划走。
先跑起来的地方,未必最开放
世界模型听起来很通用,但早期落地反而可能出现在约束更强的场景里。
预测需要边界。工业装配、仓储搬运、特定工位操作,物体种类、空间范围、动作流程更稳定,模型更容易学习环境变化。家庭服务场景更复杂,软硬材质混在一起,人会随时打断,光照和摆放方式也更随机。
所以,BIGAI如果要验证世界模型路线,更现实的路径可能不是一开始就追求“通用家庭机器人”,而是在物理规则相对稳定、误差可度量的场景中证明价值。比如精细操作、接触状态判断、遮挡处理,这些任务里,世界模型比单纯动作模仿更有发挥空间。
自动驾驶也常被放进世界模型讨论,但它面对的是更开放的环境,安全要求更高,验证周期也更长。相比之下,机器人在半封闭场景里的物理交互,可能更适合作为早期试验场。
真正的检验在具体动作里
BIGAI押注世界模型,表面上是在跟进全球AI研究热点;往里看,是具身智能从“会执行”走向“会预判”的路线调整。
这个调整不会立刻让机器人变成通用智能体。世界模型本身还有不少问题没解决:到底该在像素空间预测,还是在表征空间预测;该依赖视频生成,还是强化学习、JEPA一类路线;如何在机器人本体算力限制下实时运行;长期因果推理能力又该怎么评估。
但方向比过去清楚了。只靠更大的VLA模型,未必能解决物理世界里的不确定性。机器人要进入真实环境,就必须知道动作可能带来什么后果。
对BIGAI来说,世界模型不是一句新口号,而是一套会牵动评估、数据、模型结构和落地顺序的工程选择。最后的检验也不会来自发布会,而会来自那些具体场景:机器人能不能在没见过的桌面、物体和干扰中,先判断,再动作,少犯低级错误。