 前沿研究
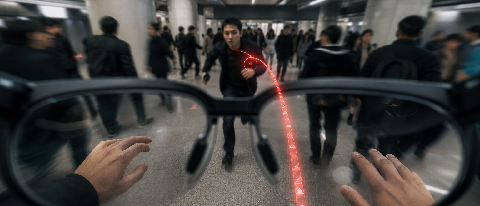
手机端跑通世界模型,2026年AI眼镜终于能预测物理碰撞了
分析端侧世界模型如何将AI眼镜从简单的“视觉识别”升级为“物理预判”。结合谷歌、三星、高通等最新硬件动态,探讨轻量化世界模型在毫秒级实时推理中解决物理碰撞预测的技术路径与功耗约束。
阅读全文关键词:高通
前沿研究
分析端侧世界模型如何将AI眼镜从简单的“视觉识别”升级为“物理预判”。结合谷歌、三星、高通等最新硬件动态,探讨轻量化世界模型在毫秒级实时推理中解决物理碰撞预测的技术路径与功耗约束。
阅读全文 产业动态
通用仍把自动驾驶列为重点方向,但公开信息存在明显缺口:Cruise在2024年底转向辅助驾驶,此前的休斯敦路测无法说明调整后的进度;自研芯片只有“预计2025年部署”的市场消息,Snapdragon座舱芯片的车型和量产时
阅读全文70B模型用FP16存权重约140GB,压到INT4仍约35GB,还没算KV Cache和其他车载任务。Thor为跨域计算留出更大余量,8775更看重座舱部署。真正影响选型的,是持续散热、算子覆盖、量化和故障隔离。
阅读全文 前沿研究
苹果把省电做进约200亿参数的稀疏模型,高通则用混合精度降低推理能耗,并称骁龙8 Gen 4端侧大模型功耗下降40%。两套方案暂时缺少统一实测,38TOPS也不能代替持续运行时的温度、降频和适配成本。
阅读全文 技术应用
CT-X1用3nm制程、400 TOPS算力和130亿参数模型支持能力抬高了硬件上限,但公开资料尚无统一条件下的7B模型对测。与骁龙8295相比,真正影响上车体验的还有内存、散热、任务调度和量产适配。
阅读全文 前沿研究
Arm正推动移动AI从单点算力竞争转向整套计算栈协同。对联发科和高通来说,7B模型能否进入手机,关键还要看内存占用、软硬件适配和系统调度,现有公开材料尚不足以判断谁会率先落地。
阅读全文 产业动态
端侧大模型进入手机和PC后,芯片性能已不能只看TOPS。Arm推出Lumex CSS并引入SME2,试图从CPU、GPU、系统IP和数据搬运入手,缓解算力、内存与功耗之间的牵制。
阅读全文 前沿研究
 前沿研究
高通与Arm的授权争议、联发科对模型和开发工具的密集投入,指向同一个问题:端侧AI竞争已经压到芯片底层。Arm授权决定产品能否延续,工具与模型适配则决定AI能力能否真正交付。
阅读全文 产业动态
 产业动态
Arm 决定亲自下场做 AI 芯片,Meta 据传是首位客户。这条新闻表面看是云端战场,背后真正让手机厂商焦虑的是端侧 14B 模型部署的瓶颈——热密度和内存带宽。Arm CSS 平台和高通、联发科、苹果的路线对比,IP
阅读全文 前沿研究
基于Arm China“周易”X3的NPU动态调度思路,解决骁龙8 Gen5跑14B模型的内存溢出与前台卡顿痛点,提供算子级动态加载、内存压力感知与资源借用方案,帮助端侧开发者压榨有限算力。
阅读全文