 技术应用
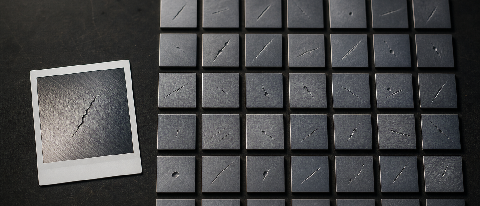
三个月只攒100张缺陷图,怎么补到1万张
一家汽车供应链企业三个月只积累到100张微裂纹图。团队用CLIP变体、潜扩散模型和ControlNet补充样本,再经视觉大模型筛选和模型蒸馏,把漏检率从8%降至1.2%,边缘侧推理延迟压到42ms。
阅读全文关键词:大模型
技术应用
一家汽车供应链企业三个月只积累到100张微裂纹图。团队用CLIP变体、潜扩散模型和ControlNet补充样本,再经视觉大模型筛选和模型蒸馏,把漏检率从8%降至1.2%,边缘侧推理延迟压到42ms。
阅读全文 产业动态
2026下半年,H200整卡按月租议价空间收窄,国产910C推理机柜签长约要排队。竞争核心已从训练侧转向推理侧——低延迟SLA、混合调度与边缘节点成为真正的稀缺资源。
阅读全文这次风控模型升级没有先补齐海量人工标签。团队把10.3万条客服与信审对话整理成23类场景,用合规、流程和客户体验三类规则给模型打分,再以Qwen2.5-7B-Instruct配合LoRA,在单张RTX 4090上训练约3
阅读全文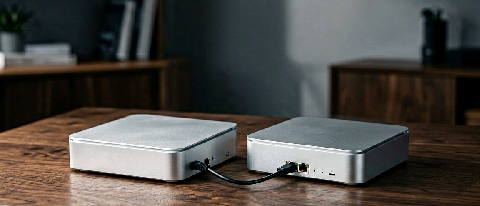 AI 实操指南
利用两台闲置Mac Studio(M2/M3 Max),通过llama.cpp RPC分布式推理运行14B开源模型,实测吞吐与云GPU成本对比,附完整部署步骤。
阅读全文针对2026年7月具身智能大模型的高昂训练成本与落地幻觉,北京通用人工智能研究院(通研院)提出了一种新解法:舍弃端到端多模态预训练,在极简仿真沙盒中通过物理因果反馈跑通物理Agent的常识推理,为中小具身智能创业团队提供
阅读全文分析大模型训练从“规模至上”转向“推理能力驱动”的技术拐点。重点拆解 GRPO 算法如何通过取消 Critic 模型降低显存成本,使 7B-70B 小参数模型能通过大规模强化学习实现性能反超,揭示 2026 年模型训练的
阅读全文安谋科技在2024年提出,100亿参数级大模型已成为现有终端设备的最佳匹配规格。模型进手机后,用户先感受到的是弱网下仍可处理部分任务、敏感数据少上传和响应更直接;内存、功耗与模型更新,则决定它仍需云端配合。
阅读全文2026年7月Sora 3上线10分钟长视频,但行业焦点已转向实时交互。本文分析Transformer架构在视频流处理中的优化,探讨低延迟渲染如何颠覆直播、游戏与元宇宙产业,并引用IDC报告指出中国多模态大模型在交互性上
阅读全文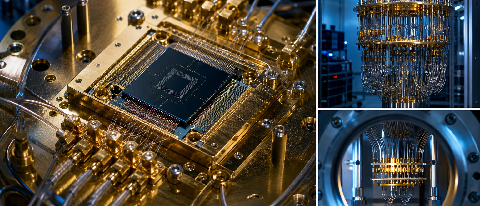 前沿研究
2026年6月,Google与IBM在量子纠错领域接连宣布里程碑,标志着容错量子计算进入工程化深水区。本文对比表面码与拓扑量子比特的实测数据,结合“清醒异构”等企业的经典模拟策略,分析量子算力何时能真正解决AI大模型中的
阅读全文2026年端侧AI已从跑分转向体感优化。本文通过拆解3B-7B模型的首token延迟(TTFT),分析内存带宽瓶颈与KV Cache压缩技术,探讨硬件厂商如何通过架构升级解决AI手机卡顿,揭示端侧推理的真实性能分水岭。
阅读全文 产业动态
针对2026年端侧Agent的能效瓶颈,本文拆解Arm最新AGI CPU与新能源架构如何通过内存带宽优化与微架构升级,支撑50亿参数模型在手机端实现低功耗常驻,并为开发者分析下半年端侧模型的容量上限。
阅读全文 技术应用
7B更容易在手机上落地,14B也不等于体验一定更好。面对骁龙8 Elite和天玑9400,选型要同时看内存占用、首字延迟、持续生成速度、整机功耗和降频情况。现有素材没有统一实测数据,因此不虚构芯片胜负,只给出可复现的比较
阅读全文