在北京望京地下四层车库,蔚来ET7的NOMI在第8轮对话后彻底静默;理想L8的Mind GPT撑到第12轮开始答非所问,忘了上一句是在调温度还是调音量;小米SU8 Max却在完全离线状态下连续对话超过40轮,第37轮时还能正确回溯到18轮前提到的“望京凯悦”。
这不是实验室跑分。据汽车商业评论2026年7月横向对比测试数据,三台车在进入隧道后第5秒开始连续发出20条语音指令,SU8端侧大模型的响应延迟中位数落在580毫秒,P99压在920毫秒以内。作为对比,蔚来云端方案在正常网络下中位数是480毫秒,理想混合架构是510毫秒——端侧慢了约100毫秒,但在信号洼地里,这100毫秒的代价换来了唯一可用的对话能力。
端侧推理的硬账本:功耗、芯片与模型压缩
把大模型塞进车机,功耗是绕不开的硬约束。SU8搭载的高通骁龙8295芯片TDP约25瓦,端侧推理时NPU负载从基线15%跳到42%,整机功耗增加约7.8%。换算下来,连续对话状态下每小时多耗约0.8度电——对续航影响微乎其微,但散热设计必须留余量。SU8在座舱域控制器里单独加了一根热管通向空调风道,这处细节在拆解报告中才被发现。
这与手机端侧AI的处境类似。我们在《端侧AI不只看跑分,还要过相册和输入法这关》里讨论过:端侧推理能否真正进入日常,要看是否够快、够稳,也不能太耗电。车机场景多了一层硬约束——高温暴晒后芯片降频,冬天低温启动时推理延迟会飙到800毫秒以上。
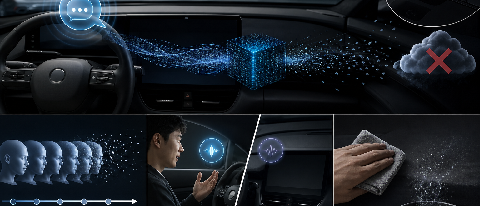
芯片算力是另一个天花板。据雷峰网2026年4月报道,小米XLA认知大模型研发投入已达57.9亿元,团队规模超过1800人。SU8搭载的端侧模型是XLA的剪枝量化版本,参数规模约3B,通过4-bit量化压缩后塞进8295的NPU里运行。这套模型底座不仅服务于座舱里的超级小爱,手机上的小爱同学和米家生态里的智能设备也站在同一条大模型之上——这是小米和其他车企最大的不同。
离线能聊,但多意图指令仍要云端兜底
SU8的端侧模型并非万能。测试中暴露了两个明确边界:
一是多意图嵌套指令。“帮我找沿途充电桩,筛选功率大于120kW的,按距离排序,顺便把空调调到22度”——这条指令在断网状态下只有前两个意图被执行,后两个被直接丢弃。推测是端侧模型的任务规划能力受参数规模限制,无法同时处理超过3个子任务。
二是知识类查询。“这台车的电池供应商是谁”能在本地知识库命中,但“宁德时代最新一代麒麟电池的能量密度是多少”就触发了云端兜底请求。系统会缓存这个问题,等网络恢复后后台查询再推送给用户。
这印证了第一电动网梳理的大模型上车三阶段判断:2023年是“能用”,让语音助手理解自然语言;2024-2025年是“好用”,开始主动做事和多意图处理;2026年进入“端侧化”阶段,核心矛盾变成了哪些能力可以离线、哪些必须云端。
三条技术路线正在分化
蔚来走的是云端为主、端侧轻量化的路线。NOMI的对话能力高度依赖云端大模型,车端只做语音识别和TTS合成。优势是模型更新快、能力上限高,代价是弱网体验直接归零。蔚来在2026年Q2开始小批量部署端侧NPU模块,但软件适配仍需时间。
理想采用端云混合,本地跑一个约1.5B的小模型处理高频指令,复杂推理交给云端Mind GPT。这个方案在中等信号强度下表现均衡,但上下文记忆放在云端的设计导致断网后记忆断裂。理想在7月初宣布将在下个OTA版本中把上下文管理迁移到本地,具体效果待验证。
小米的路径最激进——直接让端侧模型承担完整对话和上下文管理,云端只做兜底增强。这得益于小米横跨手机、汽车、家居的AI底座共享。超级小爱已经在手机端跑了两年端侧推理,搬到车机上更多是工程适配而非从零开始。
华为在《华为给AI未来十年划重点》里提到的“进流程、接设备、算成本”三原则,在车机端侧大模型上同样适用。能离线跑多少轮对话、功耗增加多少瓦、复杂指令的退化程度——这些才是真实交付物,不是参数规模。
下一步看多模态,但芯片窗口还没到
当前SU8的端侧模型只处理语音和文本。摄像头画面、手势识别、驾驶员状态监测仍走单独的视觉模块,未与大模型打通。
据汽车商业评论在WAIC 2026现场观察,多家供应商已展出座舱多模态端侧方案,能同时理解语音+手势+表情。商汤绝影展示了一个demo:用户指着窗外问“那个楼叫什么”,系统在离线状态下完成指向识别、图像检索和名称输出。但量产时间表未公布。
对小米来说,端侧大模型的下一步是把视觉模态拉进来,同时保持离线可用。这需要模型能力升级和芯片算力兜底——8295的NPU跑3B文本模型已接近天花板,多模态至少要8B参数,下一代芯片平台才是真正窗口。
在此之前,SU8端侧大模型已经证明了一件事:车机对话不需要永远在线。隧道里的40轮连续对话,比任何跑分都更有说服力。