3B模型的端侧“慢思考”,关键不只在思维链
3B—7B小模型想在手机上多想一步,需要任务路由、短步骤推理、检索、校验和云端兜底共同工作。Qwen3与vivo、面壁智能的公开信息,把端侧问题从“能不能跑”推进到“能不能稳定完成任务”。
阅读全文解读最新AI模型、算法突破与学术进展,聚焦技术原理与创新意义。
3B—7B小模型想在手机上多想一步,需要任务路由、短步骤推理、检索、校验和云端兜底共同工作。Qwen3与vivo、面壁智能的公开信息,把端侧问题从“能不能跑”推进到“能不能稳定完成任务”。
阅读全文 前沿研究
对Llama4社区下载量前五的变体进行逻辑、代码、长文本三维度盲测,发现合并模型在长文本上平均掉6.5个百分点,逻辑和代码增益微弱。MoE架构使参数平均法失效,针对性微调才是可靠提升路径。开发者选型应回归场景评测,警惕“
阅读全文 前沿研究
20分钟、30fps的手术视频有36,000帧。模型既要从冗余画面里抓住短暂动作,又要记住前后步骤、理解解剖关系,并给出可核查的时间证据。CliPPER、VideoMind和UniMedVL分别从长时序、主动检索和医学多
阅读全文 前沿研究
针对BIGAI最新发布的通通4.0,本文通过跨天记忆与多轮决策实测,分析其端到端LTUM(长期时间统一记忆)架构如何突破通通3.0的上下文窗口限制,探讨其在复杂任务连续性上的实际表现与技术瓶颈。
阅读全文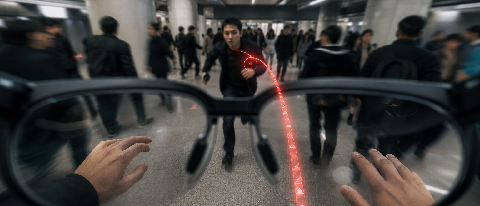 前沿研究
分析端侧世界模型如何将AI眼镜从简单的“视觉识别”升级为“物理预判”。结合谷歌、三星、高通等最新硬件动态,探讨轻量化世界模型在毫秒级实时推理中解决物理碰撞预测的技术路径与功耗约束。
阅读全文 前沿研究
会写文案、画图,不等于能稳稳抓住一颗草莓。物理AI要补上的,是感知、预测、执行和纠错组成的闭环:世界模型估计动作后果,传感器报告偏差,端侧控制在现场及时响应。
阅读全文 前沿研究
分析2026年夏季端侧AI面临的算力与散热双重挑战,探讨如何利用GRPO算法与轻量级MCTS,让3B小模型通过“慢思考”机制在本地离线实现复杂逻辑推理,并深度量化其能效比。成本账表明:慢思考的3B模型相比于大参数直接输出
阅读全文 前沿研究
Kimi K3把开源模型推到2.8万亿参数,企业部署端却在问:哪些请求真的需要旗舰模型?3B小模型的价值不在全面平替,而在任务清楚、调用频繁且有兜底的场景里,控制时延和持续成本。
阅读全文AI Agent一旦接入ERP、CRM和财务系统,直接继承用户权限会放大越权与泄漏风险。更稳妥的做法,是给Agent独立身份,并把安全网关、运行时沙箱、DLP和全链路审计放进每次工具调用。
阅读全文 前沿研究
2026年被视为L3级自动驾驶合规落地的关键节点。面对北京、上海、广州等城市开放的有条件自动驾驶试点,百度Apollo与特斯拉FSD在中国市场分别采取了“高精地图+重感知”与“端到端视觉”路线。两种路线分别对应截然不同的
阅读全文 前沿研究
vLLM更适合请求波动大、模型切换频繁的服务;TensorRT-LLM更适合NVIDIA硬件上模型稳定、愿意承担编译维护成本的场景。压测必须固定模型、精度、上下文、并发和硬件,单独的吞吐数字无法直接换算成成本。
阅读全文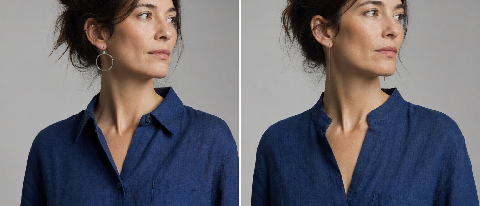 前沿研究
第1分钟还是深蓝色亚麻衬衫,第5分钟耳钉和领口已经变样。Sora 3、Runway Gen-4把单镜头做得更精细后,长视频的时间一致性问题更加显眼。3D先验可锁住场景,角色LoRA可约束身份,但会换来更高显存占用和更慢推
阅读全文