智驾大模型,别再只吵端到端
如果还把2026年的城市NOA讨论成“端到端打败规则”,问题就有点窄了。
端到端当然重要。它把感知、预测、规划、控制之间的人工分层打薄,靠数据直接学习驾驶行为,确实让很多过去难处理的路口、加塞、绕障场景变得更像人开车。但车不是只在演示视频里跑。雨雾、施工、非机动车横穿、无保护左转,这些场景里,系统既要会判断,也要知道什么时候该保守。
所以现在更值得看的,不是谁把“端到端”四个字喊得更响,而是谁能把大模型、规则、安全冗余和工程落地缝在一起。
争论换了题目:从会开车,到理解物理世界
钛媒体关于CVPR 2026的报道提到,今年智能驾驶的技术叙事正在从端到端走向物理AI基座模型。CVPR 2026在美国丹佛开幕,会上还首次开设了具身智能基座模型部署研讨会,特斯拉AI软件副总裁Ashok Elluswamy、小鹏集团通用智能中心负责人刘先明等产业一线技术负责人参与分享。
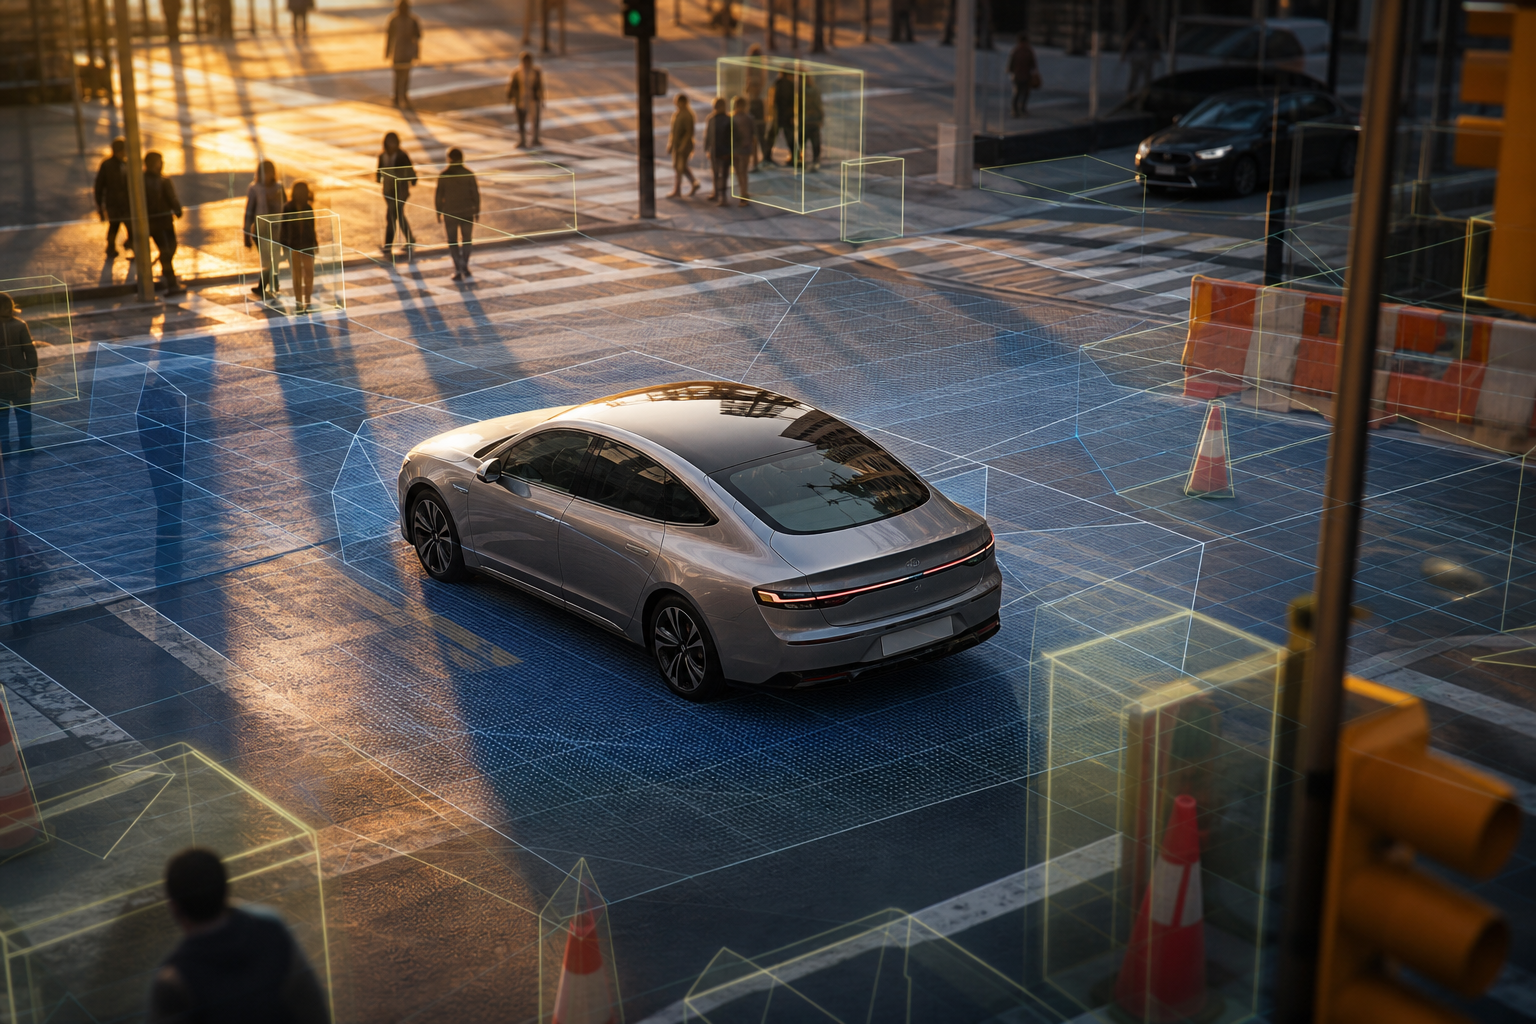
这说明行业关注点变了。过去自动驾驶更像是在回答“摄像头看到了什么”;现在的问题是,“这个世界接下来会怎么变化”。前车为什么减速,旁边电动车会不会突然切入,施工围挡后面是否可能出现行人,这些都不是单帧识别能解决的。
《2026智驾平权报告》也提到,多模态大模型和强化学习训练模式引入后,智驾端到端模型正在向VLA范式演进。VLA也就是Vision-Language-Action,把视觉、语言理解和行动决策放进同一套框架里,目标是提升推理与决策能力。
这不是给车加一个会聊天的大模型那么简单。对城市NOA来说,真正有用的是让系统更好地理解道路语义和交通参与者意图,而不是只在规则表里查下一步该做什么。
小鹏、华为、卓驭,差别不只是名字
小鹏XNGP常被放在端到端路线里讨论。它的看点在于,系统试图用大量真实道路数据学习更连续的驾驶策略,让车辆在复杂城市道路中减少僵硬停顿。对用户来说,感受往往不是“模型结构更先进”,而是变道、跟车、汇入时更像一个熟练司机。
华为乾昆智驾则经常被拿来代表另一种取舍:在智能化能力之外,强调安全边界和工程冗余。端到端可以提升泛化能力,但量产车必须面对一个现实——当传感器置信度下降、场景判断不稳定时,系统不能只相信模型直觉。保守一点,有时反而是正确策略。
卓驭科技的路线也值得看。经济参考网报道,2026北京车展上,卓驭科技发布了其首个原生多模态基础模型。在卓驭科技的技术图景中,智能驾驶不应只是模仿人类司机行为的端到端黑盒,而要避免把决策完全交给不可解释的模型。
这类思路和“世界模型”的讨论接近:车不仅要看见当前画面,还要预测几秒之后可能发生什么。环岛、匝道汇入、无保护左转这类场景,难点往往不是识别到了几辆车,而是判断每辆车可能怎么动,以及自己怎么动才不会制造新的风险。
规则没有过时,端到端也不是万能药
端到端路线最吸引人的地方,是它有机会处理更多长尾场景。传统规则系统怕“没见过”的情况,因为规则写不到那么细;数据驱动模型如果训练充分,可能从相似场景里学到更灵活的处理方式。
但这不等于规则该被扔掉。
极端天气、道路施工、传感器受遮挡、交通参与者行为异常时,模型的判断可能变得不稳定。此时规则、安全阈值、冗余链路就像刹车系统里的机械备份,不负责炫技,但负责兜底。用户真正需要的也不是某一种技术路线赢,而是车辆在高频场景里够顺,在低置信场景里够稳。
《2026智驾大模型研究》提到,自动驾驶正从L2级向L3-L4级迭代,智驾系统由传统规则驱动,转向数据驱动加认知驱动的新架构。文章还给出一组背景数据:全球乘用车保有量约15亿辆,商用车及卡车约2.8亿辆,营运出租车约1800万辆,全球年度总行驶里程达13万亿。
这些数字提醒我们,智驾不是实验室里的单点能力竞赛。只要系统要上车、要规模化,就必须处理真实世界里大量重复、杂乱、不标准的驾驶任务。
车企真正要选的,是量产边界
2026年的另一个变化,是大模型不只进入智驾,也进入座舱和舱驾融合。
网通社报道,2026汽车生态创新大会将于7月2日在上海国家会议中心启幕,议题包括AI大模型上车、商用车智能化、舱驾融合与车路云一体化。上午场主题是“AI大模型上车,从技术突破到产业重塑”,蔚来汽车座舱人工智能负责人高杰将分享大模型时代数字座舱实践和展望。
这意味着,车企讨论的已不只是城市NOA怎么跑,还包括座舱、驾驶、云端、道路基础设施之间怎么协同。未来的智驾大模型,可能既要理解驾驶场景,也要和座舱交互、地图、车路云系统配合。
但回到用户这一侧,判断标准仍然很朴素:该走的时候别犹豫,该让的时候别冒进,遇到看不清的情况要知道慢下来。
端到端提升上限,规则和冗余守住下限。小鹏XNGP、华为乾昆、卓驭科技这些方案的差异,最后都会落在这两个问题上:它能不能在复杂城市道路里少犯错;它知不知道自己什么时候可能犯错。
这比“端到端VS规则混合”的口号更接近2026年智驾的真实竞争。